# CLIPSeg
## Aperçu
Le modèle CLIPSeg a été proposé dans [Image Segmentation Using Text and Image Prompts](https://huggingface.co/papers/2112.10003) par Timo Lüddecke et Alexander Ecker. CLIPSeg ajoute un décodeur minimal au-dessus d'un modèle [CLIP](clip) figé pour la segmentation d'images en zéro-shot et en one-shot.
L'abstract de l'article est le suivant :
*La segmentation d’images est généralement traitée en entraînant un modèle pour un ensemble fixe de classes d’objets. L’incorporation de classes supplémentaires ou de requêtes plus complexes ultérieurement est coûteuse, car elle nécessite de réentraîner le modèle sur un jeu de données qui englobe ces expressions. Nous proposons ici un système capable de générer des segmentations d’images à partir de prompts arbitraires au moment de l’inférence. Un prompt peut être soit un texte, soit une image. Cette approche nous permet de créer un modèle unifié (entraîné une seule fois) pour trois tâches courantes de segmentation, qui présentent des défis distincts : la segmentation par expression référente, la segmentation zéro-shot et la segmentation one-shot. Nous nous appuyons sur le modèle CLIP comme architecture de base, que nous étendons avec un décodeur basé sur un transformer permettant une prédiction dense. Après entraînement sur une version étendue du jeu de données PhraseCut, notre système génère une carte de segmentation binaire pour une image à partir d’un prompt texte libre ou d’une image supplémentaire exprimant la requête. Nous analysons en détail différentes variantes de ces prompts basés sur une image. Cet hybride d’entrées novateur permet une adaptation dynamique non seulement aux trois tâches de segmentation mentionnées ci-dessus, mais à toute tâche de segmentation binaire pour laquelle une requête texte ou image peut être formulée. Enfin, nous constatons que notre système s’adapte bien aux requêtes généralisées impliquant des affordances ou des propriétés*
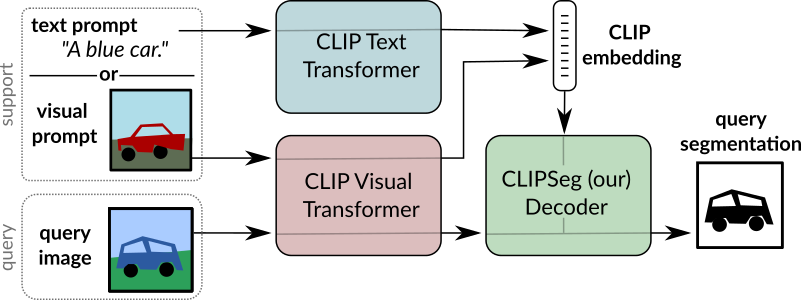 Aperçu de CLIPSeg. Tiré de l'article original.
Ce modèle a été contribué par [nielsr](https://huggingface.co/nielsr). Le code d'origine peut être trouvé [ici](https://github.com/timojl/clipseg).
## Conseils d'utilisation
- [CLIPSegForImageSegmentation](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) ajoute un décodeur au-dessus de [CLIPSegModel](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegModel). Ce dernier est identique à [CLIPModel](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPModel).
- [CLIPSegForImageSegmentation](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) peut générer des segmentations d’images à partir de prompts arbitraires au moment de l’inférence. Un prompt peut être soit un texte
(fournies au modèle sous forme de `input_ids`) ou une image (fournie au modèle sous forme de `conditional_pixel_values`). Il est également possible de fournir des embeddings conditionnels personnalisés (fournis au modèle sous forme de `conditional_embeddings`).
## Ressources
Une liste de ressources officielles Hugging Face et de la communauté (indiquées par 🌎) pour vous aider à démarrer avec CLIPSeg. Si vous souhaitez soumettre une ressource pour qu'elle soit incluse ici, n'hésitez pas à ouvrir une Pull Request et nous la examinerons ! La ressource devrait idéalement démontrer quelque chose de nouveau plutôt que de dupliquer une ressource existante.
- Un notebook illustrant [la segmentation d’images en zéro tirage avec CLIPSeg](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/CLIPSeg/Zero_shot_image_segmentation_with_CLIPSeg.ipynb).
## CLIPSegConfig[[transformers.CLIPSegConfig]]
#### transformers.CLIPSegConfig[[transformers.CLIPSegConfig]]
```python
transformers.CLIPSegConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, text_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegTextConfig | None = None, vision_config: dict | transformers.models.clipseg.configuration_clipseg.CLIPSegVisionConfig | None = None, projection_dim: int | None = 512, logit_scale_init_value: float | int | None = 2.6592, initializer_factor: float | None = 1.0, extract_layers: list[int] | tuple[int, ...] = (3, 6, 9), reduce_dim: int = 64, decoder_num_attention_heads: int = 4, decoder_attention_dropout: float | int = 0.0, decoder_hidden_act: str = 'quick_gelu', decoder_intermediate_size: int = 2048, conditional_layer: int = 0, use_complex_transposed_convolution: bool = False)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/configuration_clipseg.py#L124)
**Paramètres :**
text_config (`Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegTextConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone de texte.
vision_config (`Union[dict, ~models.clipseg.configuration_clipseg.CLIPSegVisionConfig]`, *facultatif*) : L'objet de configuration ou le dictionnaire du backbone visuel.
projection_dim (`int`, *facultatif*, valeur par défaut `512`) : Dimension des couches de projection du texte et de la vision.
logit_scale_init_value (`Union[float, int]`, *facultatif*, valeur par défaut `2.6592`) : La valeur initiale du paramètre *logit_scale*.
initializer_factor (`float`, *facultatif*, par défaut `1.0`) : Un facteur pour l'initialisation de toutes les matrices de poids (doit être maintenu à 1, utilisé en interne pour les tests d'initialisation).
extract_layers (`list[int]`, *facultatif*, valeur par défaut `[3, 6, 9]`) : Couches à extraire lors du passage de l'image de requête à travers le backbone visuel figé de CLIP.
reduce_dim (`int`, *facultatif*, valeur par défaut : 64) : Dimensionnalité à laquelle réduire l'embedding visuel CLIP.
decoder_num_attention_heads (`int`, *facultatif*, valeur par défaut `4`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
decoder_attention_dropout (`Union[float, int]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout appliqué aux probabilités d'attention.
decoder_hidden_act (`str`, *facultatif*, par défaut `quick_gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
decoder_intermediate_size (`int`, *facultatif*, valeur par défaut `2048`) : Dimension des représentations MLP.
conditional_layer (`int`, *facultatif*, valeur par défaut 0) : La couche de l'encodeur Transformer dont les activations seront combinées avec les embeddings de condition à l'aide de FiLM (Feature-wise Linear Modulation). Si la valeur est 0, la dernière couche est utilisée.
use_complex_transposed_convolution (`bool`, *facultatif*, valeur par défaut `False`) : Indique s'il faut utiliser une convolution transposée plus complexe dans le décodeur, permettant une segmentation plus fine.
Ceci est la classe de configuration destinée à stocker la configuration d'un CLIPSegModel. Elle est utilisée pour instancier un modèle Clipseg en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import CLIPSegConfig, CLIPSegModel
>>> # Initializing a CLIPSegConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegConfig()
>>> # Initializing a CLIPSegModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a CLIPSegConfig from a CLIPSegTextConfig and a CLIPSegVisionConfig
>>> # Initializing a CLIPSegText and CLIPSegVision configuration
>>> config_text = CLIPSegTextConfig()
>>> config_vision = CLIPSegVisionConfig()
>>> config = CLIPSegConfig(text_config=config_text, vision_config=config_vision)
```
## CLIPSegTextConfig[[transformers.CLIPSegTextConfig]]
#### transformers.CLIPSegTextConfig[[transformers.CLIPSegTextConfig]]
```python
transformers.CLIPSegTextConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 49408, hidden_size: int = 512, intermediate_size: int = 2048, num_hidden_layers: int = 12, num_attention_heads: int = 8, max_position_embeddings: int = 77, hidden_act: str = 'quick_gelu', layer_norm_eps: float | None = 1e-05, attention_dropout: int | float | None = 0.0, initializer_range: float = 0.02, initializer_factor: float | None = 1.0, pad_token_id: int | None = 1, bos_token_id: int | None = 49406, eos_token_id: int | list[int] | None = 49407)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/configuration_clipseg.py#L31)
**Paramètres :**
vocab_size (`int`, *facultatif*, valeur par défaut `49408`) : Taille du vocabulaire du modèle. Définit le nombre de jetons différents qui peuvent être représentés par `input_ids`.
hidden_size (`int`, *facultatif*, par défaut `512`) : Dimension des représentations cachées.
intermediate_size (`int`, *facultatif*, valeur par défaut `2048`) : Dimension des représentations MLP.
num_hidden_layers (`int`, *facultatif*, par défaut `12`) : Nombre de couches cachées dans le décodeur Transformer.
num_attention_heads (`int`, *facultatif*, valeur par défaut `8`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
max_position_embeddings (`int`, *facultatif*, valeur par défaut `77`) : La longueur de séquence maximale avec laquelle ce modèle pourrait être utilisé.
hidden_act (`str`, *facultatif*, par défaut `quick_gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *facultatif*, valeur par défaut `1e-05`) : L'épsilon utilisé par les couches de normalisation de couche.
attention_dropout (`Union[int, float]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout appliqué aux probabilités d'attention.
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
initializer_factor (`float`, *facultatif*, par défaut `1.0`) : Un facteur pour l'initialisation de toutes les matrices de poids (doit être maintenu à 1, utilisé en interne pour les tests d'initialisation).
pad_token_id (`int`, *facultatif*, valeur par défaut `1`) : Identifiant du jeton utilisé pour le bourrage dans le vocabulaire.
bos_token_id (`int`, *facultatif*, valeur par défaut `49406`) : Identifiant du jeton utilisé pour le début de flux dans le vocabulaire.
eos_token_id (`Union[int, list[int]]`, *facultatif*, valeur par défaut `49407`) : Identifiant de jeton utilisé pour la fin de flux dans le vocabulaire.
Ceci est la classe de configuration destinée à stocker la configuration d'un CLIPSegModel. Elle est utilisée pour instancier un modèle Clipseg en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import CLIPSegTextConfig, CLIPSegTextModel
>>> # Initializing a CLIPSegTextConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegTextConfig()
>>> # Initializing a CLIPSegTextModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegTextModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## CLIPSegVisionConfig[[transformers.CLIPSegVisionConfig]]
#### transformers.CLIPSegVisionConfig[[transformers.CLIPSegVisionConfig]]
```python
transformers.CLIPSegVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, intermediate_size: int = 3072, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] | None = 224, patch_size: int | list[int] | tuple[int, int] | None = 32, hidden_act: str = 'quick_gelu', layer_norm_eps: float = 1e-05, attention_dropout: int | float | None = 0.0, initializer_range: float = 0.02, initializer_factor: float = 1.0)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/configuration_clipseg.py#L80)
**Paramètres :**
hidden_size (`int`, *facultatif*, par défaut `768`) : Dimension des représentations cachées.
intermediate_size (`int`, *facultatif*, par défaut `3072`) : Dimension des représentations MLP.
num_hidden_layers (`int`, *facultatif*, par défaut `12`) : Nombre de couches cachées dans le décodeur Transformer.
num_attention_heads (`int`, *facultatif*, valeur par défaut `12`) : Nombre de têtes d'attention pour chaque couche d'attention du décodeur Transformer.
num_channels (`int`, *facultatif*, par défaut `3`) : Le nombre de canaux d'entrée.
image_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `224`) : La taille (résolution) de chaque image.
patch_size (`Union[int, list[int], tuple[int, int]]`, *facultatif*, valeur par défaut `32`) : La taille (résolution) de chaque patch.
hidden_act (`str`, *facultatif*, par défaut `quick_gelu`) : La fonction d'activation non linéaire (fonction ou chaîne de caractères) dans le décodeur. Par exemple, `"gelu"`, `"relu"`, `"silu"`, etc.
layer_norm_eps (`float`, *facultatif*, valeur par défaut `1e-05`) : L'épsilon utilisé par les couches de normalisation de couche.
attention_dropout (`Union[int, float]`, *facultatif*, valeur par défaut `0.0`) : Le taux de dropout appliqué aux probabilités d'attention.
initializer_range (`float`, *facultatif*, valeur par défaut `0.02`) : L'écart-type de la truncated_normal_initializer utilisé pour l'initialisation de toutes les matrices de poids.
initializer_factor (`float`, *facultatif*, par défaut `1.0`) : Un facteur pour l'initialisation de toutes les matrices de poids (doit être maintenu à 1, utilisé en interne pour les tests d'initialisation).
Ceci est la classe de configuration destinée à stocker la configuration d'un CLIPSegModel. Elle est utilisée pour instancier un modèle Clipseg en fonction des arguments spécifiés, en définissant l'architecture du modèle. L'instanciation d'une configuration avec les valeurs par défaut produira une configuration similaire à celle de [CIDAS/clipseg-rd64](https://huggingface.co/CIDAS/clipseg-rd64)
Les objets de configuration héritent de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) et peuvent être utilisés pour contrôler les sorties du modèle. Consultez la documentation de [PreTrainedConfig](/docs/transformers/main/fr/main_classes/configuration#transformers.PreTrainedConfig) pour plus d’informations.
Exemple :
```python
>>> from transformers import CLIPSegVisionConfig, CLIPSegVisionModel
>>> # Initializing a CLIPSegVisionConfig with CIDAS/clipseg-rd64 style configuration
>>> configuration = CLIPSegVisionConfig()
>>> # Initializing a CLIPSegVisionModel (with random weights) from the CIDAS/clipseg-rd64 style configuration
>>> model = CLIPSegVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## CLIPSegProcessor[[transformers.CLIPSegProcessor]]
#### transformers.CLIPSegProcessor[[transformers.CLIPSegProcessor]]
```python
transformers.CLIPSegProcessor(image_processor = None, tokenizer = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/processing_clipseg.py#L24)
**Paramètres :**
image_processor (`ViTImageProcessor`) : le processeur d'images est une entrée obligatoire.
tokenizer (`CLIPTokenizer`) : le tokenizer est une entrée obligatoire.
Construit un CLIPSegProcessor qui encapsule un processeur d’images et un tokenizer en un seul processeur.
[CLIPSegProcessor](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegProcessor) offre toutes les fonctionnalités de [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor) et de [CLIPTokenizer](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPTokenizer). Consultez [~ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor) et [~CLIPTokenizer](/docs/transformers/main/fr/model_doc/clip#transformers.CLIPTokenizer) pour plus d’informations.
#### __appel__[[transformers.CLIPSegProcessor.__call__]]
```python
__call__(text = None, images = None, visual_prompt = None, **kwargs)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/processing_clipseg.py#L28)
**Paramètres :**
text (``) : The sequence or batch of sequences to be encoded. Each sequence can be a string or a list of strings (pretokenized string). If you pass a pretokenized input, set `is_split_into_words=True` to avoid ambiguity with batched inputs.
images (``) : Image to preprocess. Expects a single or batch of images with pixel values ranging from 0 to 255. If passing in images with pixel values between 0 and 1, set `do_rescale=False`.
visual_prompt (`PIL.Image.Image`, `np.ndarray`, `torch.Tensor`, `list[PIL.Image.Image]`, `list[np.ndarray]`, `list[torch.Tensor]`) : L'image de prompt visuel ou le lot d'images à préparer. Chaque image de prompt visuel peut être une image PIL, un tableau NumPy ou un tenseur PyTorch. Dans le cas d'un tableau NumPy/d'un tenseur PyTorch, chaque image doit avoir la forme (C, H, W), où C est le nombre de canaux, et H et W sont la hauteur et la largeur de l'image.
return_tensors (`str` ou [TensorType](/docs/transformers/main/fr/internal/file_utils#transformers.TensorType), *facultatif*) : Si défini, renverra des tenseurs d'un framework particulier. Les valeurs acceptables sont : - `'pt'` : Renvoie des objets `torch.Tensor` de PyTorch. - `'np'` : Renvoie des objets `np.ndarray` de NumPy.
**Retourne :** [BatchEncoding](/docs/transformers/main/fr/main_classes/tokenizer#transformers.BatchEncoding)
Un [BatchEncoding](/docs/transformers/main/fr/main_classes/tokenizer#transformers.BatchEncoding) avec les champs suivants :
- **input_ids** -- Liste des identifiants de jetons à fournir au modèle. Renvoyé lorsque `text` n'est pas `None`.
- **attention_mask** -- Liste d'indices spécifiant les jetons auxquels le modèle doit prêter attention (lorsque `return_attention_mask=True` ou si *"attention_mask"* est présent dans `self.model_input_names` et si `text` n'est pas `None`).
- **pixel_values** -- Valeurs des pixels à fournir à un modèle. Renvoyé lorsque `images` n'est pas `None`.
## CLIPSegModel[[transformers.CLIPSegModel]]
#### transformers.CLIPSegModel[[transformers.CLIPSegModel]]
```python
transformers.CLIPSegModel(config: CLIPSegConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L783)
**Paramètres :**
config ([CLIPSegConfig](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle Clipseg brut, qui produit des états cachés bruts sans aucune tête spécifique au sommet.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.CLIPSegModel.forward]]
```python
forward(input_ids: typing.Optional[torch.LongTensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, return_loss: bool | None = None, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L877)
**Paramètres :**
input_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor). Voir [ViTImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([CLIPSegProcessor](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegProcessor) utilise [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor) pour le traitement des images).
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
position_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des positions des jetons de chaque séquence d'entrée dans les embeddings de position. Sélectionnés dans l'intervalle `[0, config.n_positions - 1]`. [Que sont les identifiants de position ?](../glossary#position-ids)
return_loss (`bool`, *facultatif*) : Indique s'il faut ou non retourner la perte contrastive.
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** `CLIPSegOutput` ou `tuple(torch.Tensor)`
Un `CLIPSegOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([CLIPSegConfig](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegConfig)) et les entrées.
La méthode forward du modèle [CLIPSegModel](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `return_loss` est `True`) -- Perte contrastive pour la similarité image-texte.
- **logits_per_image** (`torch.Tensor` de forme `(image_batch_size, text_batch_size)`) -- Les scores de produit scalaire normalisé entre `image_embeds` et `text_embeds`. Cela représente les scores de similarité image-texte.
- **logits_per_text** (`torch.Tensor` de forme `(text_batch_size, image_batch_size)`) -- Les scores de produit scalaire normalisé entre `text_embeds` et `image_embeds`. Cela représente les scores de similarité texte-image.
- **text_embeds** (`torch.Tensor` de forme `(batch_size, output_dim`) -- Les embeddings de texte obtenus en appliquant la couche de projection à la sortie agrégée de [CLIPSegTextModel](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegTextModel).
- **image_embeds** (`torch.Tensor` de forme `(batch_size, output_dim`) -- Les embeddings d'image obtenus en appliquant la couche de projection à la sortie agrégée de [CLIPSegVisionModel](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegVisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) -- La sortie du [CLIPSegTextModel](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) -- La sortie du [CLIPSegVisionModel](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegVisionModel).
Exemples :
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(
... text=["a photo of a cat", "a photo of a dog"], images=image, return_tensors="pt", padding=True
... )
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> logits_per_image = outputs.logits_per_image # this is the image-text similarity score
>>> probs = logits_per_image.softmax(dim=1) # we can take the softmax to get the label probabilities
```
#### get_text_features[[transformers.CLIPSegModel.get_text_features]]
```python
get_text_features(input_ids: Tensor, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L804)
**Paramètres :**
input_ids (`torch.Tensor` de forme `(batch_size, sequence_length)`) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
position_ids (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des positions des jetons de chaque séquence d'entrée dans les embeddings de position. Sélectionnés dans l'intervalle `[0, config.n_positions - 1]`. [Que sont les position IDs ?](../glossary#position-ids)
**Retourne :** [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([CLIPSegConfig](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegConfig)) et les entrées.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> import torch
>>> from transformers import AutoTokenizer, CLIPSegModel
>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... text_features = model.get_text_features(**inputs)
```
#### get_image_features[[transformers.CLIPSegModel.get_image_features]]
```python
get_image_features(pixel_values: Tensor, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L839)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`) : Les tenseurs correspondant aux images d’entrée. Les valeurs des pixels peuvent être obtenues à l’aide de [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor). Voir [ViTImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([CLIPSegProcessor](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegProcessor) utilise [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor) pour le traitement des images).
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([CLIPSegConfig](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegConfig)) et les entrées.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegModel
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> inputs = processor(images=image, return_tensors="pt")
>>> with torch.inference_mode():
... image_features = model.get_image_features(**inputs)
```
## CLIPSegTextModel[[transformers.CLIPSegTextModel]]
#### transformers.CLIPSegTextModel[[transformers.CLIPSegTextModel]]
```python
transformers.CLIPSegTextModel(config: CLIPSegTextConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L594)
**Paramètres :**
config ([CLIPSegTextConfig](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegTextConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle de texte de CLIPSEG, sans aucune tête ni projection au-dessus.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.CLIPSegTextModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L610)
**Paramètres :**
input_ids (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
position_ids (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des positions des jetons de chaque séquence d'entrée dans les embeddings de position. Sélectionnés dans l'intervalle `[0, config.n_positions - 1]`. [Que sont les position IDs ?](../glossary#position-ids)
**Retourne :** [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([CLIPSegConfig](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegConfig)) et les entrées.
La méthode forward du modèle [CLIPSegTextModel](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegTextModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from transformers import AutoTokenizer, CLIPSegTextModel
>>> tokenizer = AutoTokenizer.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegTextModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> inputs = tokenizer(["a photo of a cat", "a photo of a dog"], padding=True, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled (EOS token) states
```
## CLIPSegVisionModel[[transformers.CLIPSegVisionModel]]
#### transformers.CLIPSegVisionModel[[transformers.CLIPSegVisionModel]]
```python
transformers.CLIPSegVisionModel(config: CLIPSegVisionConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L694)
**Paramètres :**
config ([CLIPSegVisionConfig](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegVisionConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Le modèle de vision de CLIPSEG, sans aucune tête ni projection au sommet.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.CLIPSegVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor], interpolate_pos_encoding: bool | None = True, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L710)
**Paramètres :**
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor). Voir [ViTImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([CLIPSegProcessor](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegProcessor) utilise [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor) pour le traitement des images).
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou `tuple(torch.Tensor)`
Un [BaseModelOutputWithPooling](/docs/transformers/main/fr/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithPooling) ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([CLIPSegConfig](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegConfig)) et les entrées.
La méthode forward du [CLIPSegVisionModel](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegVisionModel) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **last_hidden_state** (`torch.Tensor` de forme `(batch_size, sequence_length, hidden_size)`) -- Séquence d'états cachés à la sortie de la dernière couche du modèle.
- **pooler_output** (`torch.Tensor` de forme `(batch_size, hidden_size)`) -- État caché de la dernière couche du premier jeton de la séquence (jeton de classification) après un traitement supplémentaire par les couches utilisées pour la tâche de pré-entraînement auxiliaire. Par exemple, pour les modèles de la famille BERT, cela renvoie le jeton de classification après traitement par une couche linéaire et une fonction d'activation tanh. Les poids de la couche linéaire sont entraînés à partir de l'objectif de prédiction de la phrase suivante (classification) pendant le pré-entraînement.
- **hidden_states** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_hidden_states=True` est passé ou lorsque `config.output_hidden_states=True`) -- Tuple de `torch.Tensor` (un pour la sortie des embeddings, si le modèle possède une couche d’embedding, + un pour la sortie de chaque couche) de forme `(batch_size, sequence_length, hidden_size)`.
États cachés du modèle à la sortie de chaque couche, ainsi que les sorties d'incorporation initiales facultatives.
- **attentions** (`tuple(torch.Tensor)`, *facultatif*, renvoyé lorsque `output_attentions=True` est passé ou lorsque `config.output_attentions=True`) -- Tuple de `torch.Tensor` (un par couche) de forme `(batch_size, num_heads, sequence_length, sequence_length)`.
Pondérations des attentions après le softmax d'attention, utilisées pour calculer la moyenne pondérée dans les têtes d'auto-attention.
Exemples :
```python
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from PIL import Image
>>> from transformers import AutoProcessor, CLIPSegVisionModel
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegVisionModel.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> inputs = processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_state = outputs.last_hidden_state
>>> pooled_output = outputs.pooler_output # pooled CLS states
```
## CLIPSegForImageSegmentation[[transformers.CLIPSegForImageSegmentation]]
#### transformers.CLIPSegForImageSegmentation[[transformers.CLIPSegForImageSegmentation]]
```python
transformers.CLIPSegForImageSegmentation(config: CLIPSegConfig)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L961)
**Paramètres :**
config ([CLIPSegConfig](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegConfig)) : Classe de configuration du modèle contenant tous les paramètres du modèle. L'initialisation à partir d'un fichier de configuration ne charge pas les poids associés au modèle, uniquement la configuration. Consultez la méthode [from_pretrained()](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel.from_pretrained) pour charger les poids du modèle.
Modèle CLIPSeg doté d'un décodeur basé sur un Transformer pour la segmentation d'images en mode zéro-shot et one-shot.
Ce modèle hérite de [PreTrainedModel](/docs/transformers/main/fr/main_classes/model#transformers.PreTrainedModel). Consultez la documentation de la classe parente pour les méthodes génériques que la bibliothèque implémente pour tous ses modèles (tels que le téléchargement ou l'enregistrement, le redimensionnement des embeddings d'entrée, l'élagage des têtes, etc.).
Ce modèle est également une sous-classe de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Utilisez-le comme un module PyTorch standard et consultez la documentation de PyTorch pour tout ce qui concerne l’utilisation et le comportement généraux.
#### forward[[transformers.CLIPSegForImageSegmentation.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, pixel_values: typing.Optional[torch.Tensor] = None, conditional_pixel_values: typing.Optional[torch.Tensor] = None, conditional_embeddings: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.LongTensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = True, **kwargs: *)
```
[Source](https://github.com/huggingface/transformers/blob/main/src/transformers/models/clipseg/modeling_clipseg.py#L1001)
**Paramètres :**
input_ids (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des jetons de la séquence d'entrée dans le vocabulaire. Le bourrage (padding) sera ignoré par défaut. Les indices peuvent être obtenus à l'aide de [AutoTokenizer](/docs/transformers/main/fr/model_doc/auto#transformers.AutoTokenizer). Consultez [PreTrainedTokenizer.encode()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) et [PreTrainedTokenizer.__call__()](/docs/transformers/main/fr/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) pour plus de détails. [Que sont les identifiants d'entrée ?](../glossary#input-ids)
pixel_values (`torch.Tensor` de forme `(batch_size, num_channels, image_size, image_size)`, *facultatif*) : Les tenseurs correspondant aux images d’entrée. Les valeurs de pixels peuvent être obtenues à l’aide de [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor). Voir [ViTImageProcessor.__call__()](/docs/transformers/main/fr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) pour plus de détails ([CLIPSegProcessor](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegProcessor) utilise [ViTImageProcessor](/docs/transformers/main/fr/model_doc/vit#transformers.ViTImageProcessor) pour le traitement des images).
conditional_pixel_values (`torch.Tensor`, *facultatif*) : Les valeurs de pixels des images conditionnelles.
conditional_embeddings (`torch.Tensor` de forme `(batch_size, config.projection_dim)`, *facultatif*) : Les embeddings conditionnels pour les images de requête. S'ils sont fournis, le modèle les utilisera au lieu de calculer les embeddings à partir de conditional_pixel_values.
attention_mask (`torch.Tensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Masque pour éviter d'appliquer l'attention aux indices des jetons de bourrage. Les valeurs du masque sont choisies dans `[0, 1]` : - 1 pour les jetons qui ne sont **pas masqués**, - 0 pour les jetons qui sont **masqués**. [Qu'est-ce qu'un masque d'attention ?](../glossary#attention-mask)
position_ids (`torch.LongTensor` de forme `(batch_size, sequence_length)`, *facultatif*) : Indices des positions des jetons de chaque séquence d'entrée dans les embeddings de position. Sélectionnés dans l'intervalle `[0, config.n_positions - 1]`. [Que sont les identifiants de position ?](../glossary#position-ids)
labels (`torch.Tensor` de forme `(batch_size, height, width)`, *facultatif*) : Masques de segmentation de référence, avec des valeurs dans `[0, 1]` et la même taille spatiale que `logits`. Une perte d'entropie croisée binaire est calculée entre les logits prédits et ces masques.
interpolate_pos_encoding (`bool`, *facultatif*, valeur par défaut `True`) : Indique s'il faut interpoler les encodages de position pré-entraînés.
**Retourne :** `CLIPSegOutput` ou `tuple(torch.Tensor)`
Un `CLIPSegOutput` ou un tuple de `torch.Tensor` (si `return_dict=False` est passé ou lorsque `config.return_dict=False`) comprenant divers éléments selon la configuration ([CLIPSegConfig](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegConfig)) et les entrées.
La méthode forward de [CLIPSegForImageSegmentation](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegForImageSegmentation) redéfinit la méthode spéciale `__call__`.
Bien que la recette de la passe avant doive être définie dans cette fonction, il faut ensuite appeler l'instance `Module` plutôt que celle-ci, car la première gère l'exécution des étapes de prétraitement et de post-traitement, tandis que la seconde les ignore silencieusement.
- **loss** (`torch.Tensor` de forme `(1,)`, *facultatif*, renvoyé lorsque `return_loss` est `True`) -- Perte contrastive pour la similarité image-texte.
- **logits_per_image** (`torch.Tensor` de forme `(image_batch_size, text_batch_size)`) -- Les scores de produit scalaire normalisé entre `image_embeds` et `text_embeds`. Cela représente les scores de similarité image-texte.
- **logits_per_text** (`torch.Tensor` de forme `(text_batch_size, image_batch_size)`) -- Les scores de produit scalaire normalisé entre `text_embeds` et `image_embeds`. Cela représente les scores de similarité texte-image.
- **text_embeds** (`torch.Tensor` de forme `(batch_size, output_dim`) -- Les embeddings de texte obtenus en appliquant la couche de projection à la sortie agrégée de [CLIPSegTextModel](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegTextModel).
- **image_embeds** (`torch.Tensor` de forme `(batch_size, output_dim`) -- Les embeddings d'image obtenus en appliquant la couche de projection à la sortie agrégée de [CLIPSegVisionModel](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegVisionModel).
- **text_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) -- La sortie du [CLIPSegTextModel](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegTextModel).
- **vision_model_output** (`~modeling_outputs.BaseModelOutputWithPooling`, *facultatif*) -- La sortie du [CLIPSegVisionModel](/docs/transformers/main/fr/model_doc/clipseg#transformers.CLIPSegVisionModel).
Exemples :
```python
>>> import torch
>>> from transformers import AutoProcessor, CLIPSegForImageSegmentation
>>> from transformers.image_utils import load_image
>>> processor = AutoProcessor.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> model = CLIPSegForImageSegmentation.from_pretrained("CIDAS/clipseg-rd64-refined")
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = load_image(url)
>>> texts = ["a cat", "a remote", "a blanket"]
>>> inputs = processor(text=texts, images=[image] * len(texts), padding=True, return_tensors="pt")
>>> with torch.inference_mode():
... outputs = model(**inputs)
>>> logits = outputs.logits
>>> print(logits.shape)
torch.Size([3, 352, 352])
```