# SAM
## 개요
SAM (Segment Anything Model)은 Alexander Kirillov, Eric Mintun, Nikhila Ravi, Hanzi Mao, Chloe Rolland, Laura Gustafson, Tete Xiao, Spencer Whitehead, Alex Berg, Wan-Yen Lo, Piotr Dollar, Ross Girshick에 의해 [Segment Anything](https://huggingface.co/papers/2304.02643)에서 제안되었습니다.
모델은 입력 이미지를 제공하면 관심 대상인 모든 객체의 분할 마스크를 예측하는 데 사용할 수 있습니다.
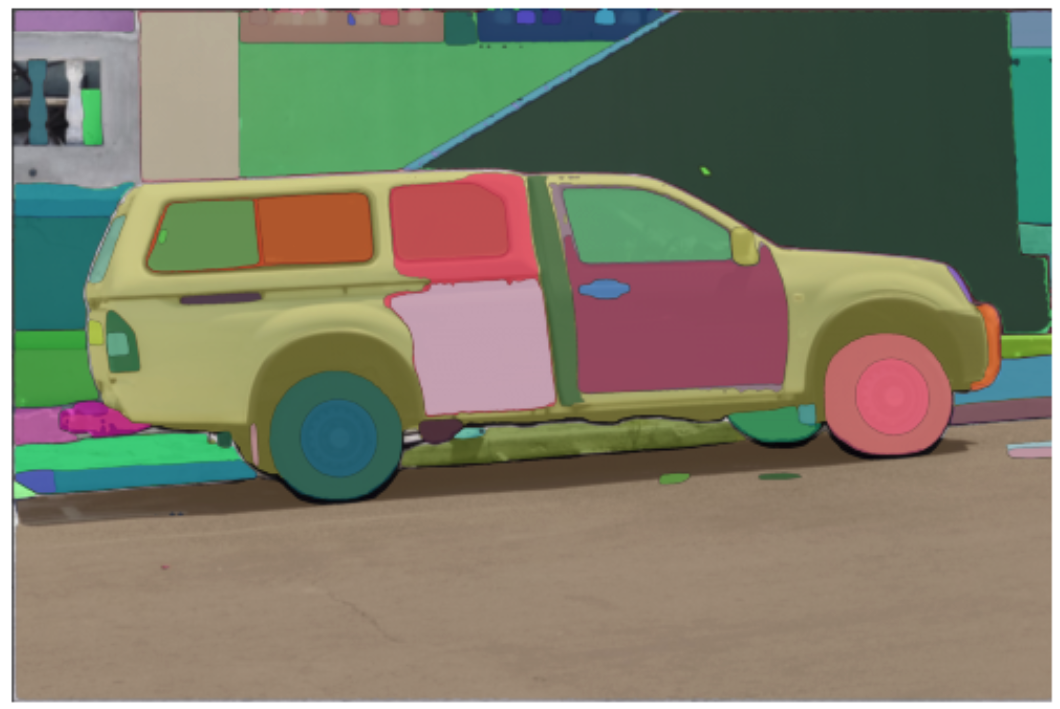
해당 논문의 초록은 다음과 같습니다:
*Segment Anything(SA) 프로젝트를 소개합니다: 이미지 분할을 위한 새로운 작업, 모델, 데이터셋입니다. 효율적인 모델을 데이터 수집 루프에 활용하여, 1,100만 장의 라이선스 및 프라이버시 준수 이미지에 10억 개 이상의 마스크를 포함하는, 지금까지 가장 큰 분할 데이터셋을 구축했습니다. 모델은 프롬프트 가능하도록 설계 및 학습되어, 새로운 이미지 분포 및 작업에 제로샷으로 이전할 수 있습니다. 다양한 작업에서 그 기능을 평가한 결과, 제로샷 성능이 인상적이며, 종종 기존의 완전 감독 학습 결과와 경쟁하거나 심지어 이를 능가하는 것으로 나타났습니다. 컴퓨터 비전 기반 모델에 대한 연구를 촉진하기 위해, Segment Anything Model(SAM)과 10억 개의 마스크 및 1,100만 장의 이미지를 포함하는 대응 데이터셋(SA-1B)을 [https://segment-anything.com](https://segment-anything.com)에서 공개합니다.*
팁:
- 모델은 주어진 이미지에서 관심 대상의 존재 여부를 나타내는 바이너리 마스크를 예측합니다.
- 입력 2D 점과/또는 입력 바운딩 박스가 제공되면 모델이 훨씬 더 나은 결과를 예측합니다
- … 같은 이미지에 대해 여러 지점을 프롬프트로 지정하고 단일 마스크를 예측할 수 있습니다.
- 모델의 Fine-tuning은 아직 지원되지 않습니다
- 해당 논문에서는 텍스트 입력도 지원되어야 한다고 명시되어 있습니다. 그러나 이 문서를 작성하는 시점 itibar로 [공식 저장소](https://github.com/facebookresearch/segment-anything/issues/4#issuecomment-1497626844)에 따르면 아직 지원되지 않는 것으로 보입니다.
이 모델은 [ybelkada](https://huggingface.co/ybelkada)와 [ArthurZ](https://huggingface.co/ArthurZ)가 기여했습니다. 원본 코드는 [여기](https://github.com/facebookresearch/segment-anything)에서 찾을 수 있습니다.
… 이미지와 2D 점을 입력으로 받아 마스크를 생성하는 방법의 예시입니다:
```python
import requests
import torch
from PIL import Image
from transformers import SamModel, SamProcessor
model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")
img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
input_points = [[[450, 600]]] # 2D location of a window in the image
inputs = processor(raw_image, input_points=input_points, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(
outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
```
프로세서를 통해 입력 이미지와 함께 자체 마스크를 처리하여 모델에 전달할 수도 있습니다.
```python
import requests
import torch
from PIL import Image
from transformers import SamModel, SamProcessor
model = SamModel.from_pretrained("facebook/sam-vit-huge", device_map="auto")
processor = SamProcessor.from_pretrained("facebook/sam-vit-huge")
img_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
raw_image = Image.open(requests.get(img_url, stream=True).raw).convert("RGB")
mask_url = "https://huggingface.co/ybelkada/segment-anything/resolve/main/assets/car.png"
segmentation_map = Image.open(requests.get(mask_url, stream=True).raw).convert("1")
input_points = [[[450, 600]]] # 2D location of a window in the image
inputs = processor(raw_image, input_points=input_points, segmentation_maps=segmentation_map, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
masks = processor.image_processor.post_process_masks(
outputs.pred_masks.cpu(), inputs["original_sizes"].cpu(), inputs["reshaped_input_sizes"].cpu()
)
scores = outputs.iou_scores
```
## 리소스
SAM을 시작하는 데 도움이 되는 공식 Hugging Face 및 커뮤니티(🌎로 표시) 리소스 목록입니다.
- 모델을 사용하는 [데모 노트북](https://github.com/huggingface/notebooks/blob/main/examples/segment_anything.ipynb)
- [Demo notebook](https://github.com/huggingface/notebooks/blob/main/examples/automatic_mask_generation.ipynb)를 사용하여 자동 마스크 생성 파이프라인을 사용하는 방법입니다.
- 의료 도메인에 대해 fine-tuning된 SAM 버전인 MedSAM으로 추론을 수행하는 [Demo notebook](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/SAM/Run_inference_with_MedSAM_using_HuggingFace_Transformers.ipynb). 🌎
- [Demo notebook](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/SAM/Fine_tune_SAM_(segment_anything)_on_a_custom_dataset.ipynb)은 사용자 지정 데이터로 모델을 fine-tuning하는 데 사용됩니다. 🌎
## SlimSAM
SAM의 가지치기 버전인 SlimSAM은 Zigeng Chen 외의 [0.1% Data Makes Segment Anything Slim](https://huggingface.co/papers/2312.05284)에서 제안되었습니다. SlimSAM은 동일한 성능을 유지하면서 SAM 모델의 크기를 상당히 줄입니다.
[hub](https://huggingface.co/models?other=slimsam)에서 체크포인트를 찾을 수 있으며, SAM의 대체재로 바로 사용할 수 있습니다.
## Grounded SAM
[Grounding DINO](grounding-dino)를 SAM과 결합하여 [Grounded SAM: Assembling Open-World Models for Diverse Visual Tasks](https://huggingface.co/papers/2401.14159)에서 소개된 텍스트 기반 마스크 생성을 수행할 수 있습니다. 자세한 내용은 이 [데모 노트북](https://github.com/NielsRogge/Transformers-Tutorials/blob/master/Grounding%20DINO/GroundingDINO_with_Segment_Anything.ipynb) 🌍을 참고하세요.
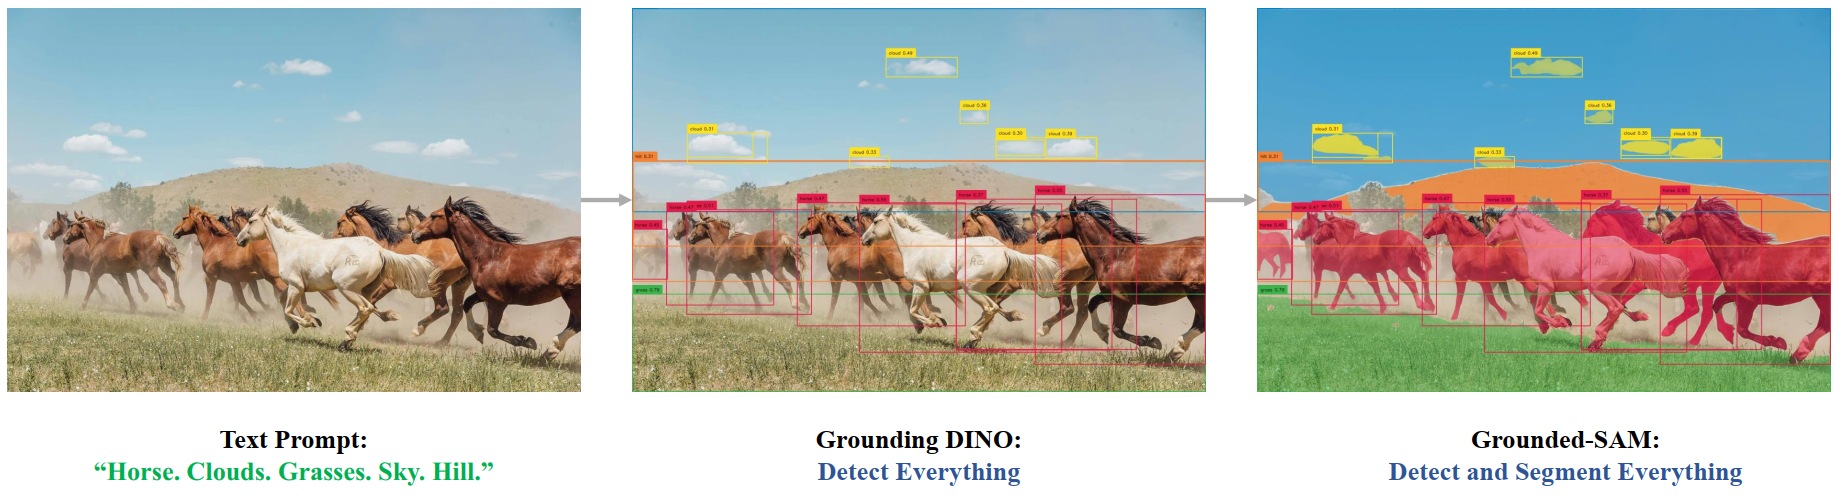 Grounded SAM 개요. 원본 저장소에서 가져왔습니다.
## SamConfig[[transformers.SamConfig]]
#### transformers.SamConfig[[transformers.SamConfig]]
```python
transformers.SamConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vision_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, prompt_encoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, mask_decoder_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, initializer_range: float = 0.02, tie_word_embeddings: bool = True)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L146)
**매개변수:**
vision_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *선택*) : 비전 백본의 config 객체 또는 사전 정의된 config 딕셔너리입니다.
prompt_encoder_config (Union[`dict`, `SamPromptEncoderConfig`], *선택*) : [SamPromptEncoderConfig](/docs/transformers/main/ko/model_doc/sam#transformers.SamPromptEncoderConfig)를 초기화하는 데 사용되는 구성 옵션의 사전.
mask_decoder_config (Union[`dict`, `SamMaskDecoderConfig`], *선택*) : [SamMaskDecoderConfig](/docs/transformers/main/ko/model_doc/sam#transformers.SamMaskDecoderConfig)를 초기화하는 데 사용되는 구성 옵션의 사전.
initializer_range (`float`, *선택 사항*, 기본값 `0.02`) : 모든 가중치 행렬을 초기화하는 truncated_normal_initializer의 표준 편차입니다.
tie_word_embeddings (`bool`, *선택 사항*, 기본값 `True`) : 모델의 `tied_weights_keys` 매핑에 따라 가중치 임베딩을 묶을지 여부.
이것은 SamModel의 구성을 저장하기 위한 구성 클래스입니다. 지정된 인자에 따라 Sam 모델을 인스턴스화하여 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 구성을 인스턴스화하면 [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)와 유사한 구성이 생성됩니다.
Configuration 객체는 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)를 상속하며, 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)의 문서를 참고하세요.
예:
```python
>>> from transformers import (
... SamVisionConfig,
... SamPromptEncoderConfig,
... SamMaskDecoderConfig,
... SamModel,
... )
>>> # Initializing a SamConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamConfig()
>>> # Initializing a SamModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
>>> # We can also initialize a SamConfig from a SamVisionConfig, SamPromptEncoderConfig, and SamMaskDecoderConfig
>>> # Initializing SAM vision, SAM Q-Former and language model configurations
>>> vision_config = SamVisionConfig()
>>> prompt_encoder_config = SamPromptEncoderConfig()
>>> mask_decoder_config = SamMaskDecoderConfig()
>>> config = SamConfig(vision_config, prompt_encoder_config, mask_decoder_config)
```
## SamVisionConfig[[transformers.SamVisionConfig]]
#### transformers.SamVisionConfig[[transformers.SamVisionConfig]]
```python
transformers.SamVisionConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 768, output_channels: int = 256, num_hidden_layers: int = 12, num_attention_heads: int = 12, num_channels: int = 3, image_size: int | list[int] | tuple[int, int] = 1024, patch_size: int | list[int] | tuple[int, int] = 16, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06, attention_dropout: float | int = 0.0, initializer_range: float = 1e-10, qkv_bias: bool = True, mlp_ratio: float = 4.0, use_abs_pos: bool = True, use_rel_pos: bool = True, window_size: int = 14, global_attn_indexes: list[int] | tuple[int, ...] = (2, 5, 8, 11), num_pos_feats: int = 128, mlp_dim: int | None = None)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L81)
**매개변수:**
hidden_size (`int`, *선택 사항*, 기본값 `768`) : 숨겨진 표현의 차원.
output_channels (`int`, *선택 사항*, 기본값 256) : Patch Encoder의 출력 채널 차원입니다.
num_hidden_layers (`int`, *선택 사항*, 기본값 `12`) : Transformer decoder의 숨겨진 레이어 수입니다.
num_attention_heads (`int`, *선택 사항*, 기본값 `12`) : Transformer decoder의 각 attention layer에 사용되는 attention head의 수입니다.
num_channels (`int`, *선택 사항*, 기본값 `3`) : 입력 채널의 수입니다.
image_size (`Union[int, list[int], tuple[int, int]]`, *선택 사항*, 기본값 `1024`) : 각 이미지의 크기(해상도).
patch_size (`Union[int, list[int], tuple[int, int]]`, *선택*, 기본값 `16`) : 각 패치의 크기(해상도).
hidden_act (`str`, *선택 사항*, 기본값 `gelu`) : 디코더에서 사용되는 비선형 활성화 함수(함수 또는 문자열). 예를 들어, `"gelu"`, `"relu"`, `"silu"` 등이 있습니다.
layer_norm_eps (`float`, *선택 사항*, 기본값 `1e-06`) : 레이어 정규화 레이어에서 사용되는 epsilon 값입니다.
attention_dropout (`Union[float, int]`, *선택 사항*, 기본값 `0.0`) : attention 확률에 적용할 dropout 비율입니다.
initializer_range (`float`, *선택 사항*, 기본값 `1e-10`) : 모든 가중치 행렬을 초기화하는 truncated_normal_initializer의 표준 편차입니다.
qkv_bias (`bool`, *선택 사항*, 기본값 `True`) : 쿼리, 키, 값에 bias를 추가할지 여부.
mlp_ratio (`float`, *선택 사항*, 기본값 `4.0`) : MLP 숨겨진 차원과 임베딩 차원의 비율입니다.
use_abs_pos (`bool`, *선택 사항*, 기본값 `True`) : 절대 위치 임베딩을 사용할지 여부.
use_rel_pos (`bool`, *선택 사항*, 기본값 `True`) : 상대 위치 임베딩을 사용할지 여부.
window_size (`int`, *선택 사항*, 기본값 14) : 상대 위치를 위한 윈도우 크기.
global_attn_indexes (`list[int]`, *선택 사항*, 기본값 `[2, 5, 8, 11]`) : 전역 어텐션 레이어의 인덱스입니다.
num_pos_feats (`int`, *선택 사항*, 기본값 128) : 위치 임베딩의 차원입니다.
mlp_dim (`int`, *선택 사항*) : Transformer 인코더의 MLP 레이어 차원입니다. `None`인 경우 기본값은 `mlp_ratio * hidden_size`입니다.
이것은 SamModel의 구성을 저장하기 위한 구성 클래스입니다. 지정된 인자에 따라 Sam 모델을 인스턴스화하여 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 구성을 인스턴스화하면 [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)와 유사한 구성이 생성됩니다.
Configuration 객체는 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)를 상속하며, 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)의 문서를 참고하세요.
예:
```python
>>> from transformers import (
... SamVisionConfig,
... SamVisionModel,
... )
>>> # Initializing a SamVisionConfig with `"facebook/sam-vit-huge"` style configuration
>>> configuration = SamVisionConfig()
>>> # Initializing a SamVisionModel (with random weights) from the `"facebook/sam-vit-huge"` style configuration
>>> model = SamVisionModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## SamMaskDecoderConfig[[transformers.SamMaskDecoderConfig]]
#### transformers.SamMaskDecoderConfig[[transformers.SamMaskDecoderConfig]]
```python
transformers.SamMaskDecoderConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 256, hidden_act: str = 'relu', mlp_dim: int = 2048, num_hidden_layers: int = 2, num_attention_heads: int = 8, attention_downsample_rate: int = 2, num_multimask_outputs: int = 3, iou_head_depth: int = 3, iou_head_hidden_dim: int = 256, layer_norm_eps: float = 1e-06)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L50)
**매개변수:**
hidden_size (`int`, *선택 사항*, 기본값 `256`) : 숨겨진 표현의 차원.
hidden_act (`str`, *선택 사항*, 기본값 `relu`) : 디코더의 비선형 활성화 함수(함수 또는 문자열). 예를 들어, `"gelu"`, `"relu"`, `"silu"` 등.
mlp_dim (`int`, *선택 사항*, 기본값 2048) : Transformer 인코더의 "중간"(즉, 피드포워드) 레이어의 차원입니다.
num_hidden_layers (`int`, *선택 사항*, 기본값 `2`) : Transformer 디코더의 숨겨진 레이어 수.
num_attention_heads (`int`, *선택 사항*, 기본값 `8`) : Transformer decoder의 각 attention layer에 사용할 attention head의 수입니다.
attention_downsample_rate (`int`, *선택 사항*, 기본값 2) : attention layer의 downsampling rate입니다.
num_multimask_outputs (`int`, *선택 사항*, 기본값 3) : `SamMaskDecoder` 모듈의 출력 개수입니다. Segment Anything 논문에서는 이 값이 3으로 설정되어 있습니다.
iou_head_depth (`int`, *선택 사항*, 기본값 3) : IoU 헤드 모듈의 레이어 수입니다.
iou_head_hidden_dim (`int`, *선택 사항*, 기본값 256) : IoU head 모듈에서 hidden states의 차원입니다.
layer_norm_eps (`float`, *선택 사항*, 기본값 `1e-06`) : 레이어 정규화 레이어에서 사용되는 epsilon 값입니다.
이것은 SamModel의 구성을 저장하기 위한 구성 클래스입니다. 지정된 인자에 따라 Sam 모델을 인스턴스화하여 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 구성을 인스턴스화하면 [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)와 유사한 구성이 생성됩니다.
Configuration 객체는 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)를 상속하며, 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)의 문서를 참고하세요.
## SamPromptEncoderConfig[[transformers.SamPromptEncoderConfig]]
#### transformers.SamPromptEncoderConfig[[transformers.SamPromptEncoderConfig]]
```python
transformers.SamPromptEncoderConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, hidden_size: int = 256, image_size: int | list[int] | tuple[int, int] = 1024, patch_size: int | list[int] | tuple[int, int] = 16, mask_input_channels: int = 16, num_point_embeddings: int = 4, hidden_act: str = 'gelu', layer_norm_eps: float = 1e-06)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/configuration_sam.py#L24)
**매개변수:**
hidden_size (`int`, *선택 사항*, 기본값 `256`) : 숨겨진 표현의 차원.
image_size (`Union[int, list[int], tuple[int, int]]`, *선택 사항*, 기본값 `1024`) : 각 이미지의 크기(해상도).
patch_size (`Union[int, list[int], tuple[int, int]]`, *선택*, 기본값 `16`) : 각 패치의 크기(해상도).
mask_input_channels (`int`, *선택 사항*, 기본값 16) : `MaskDecoder` 모듈에 전달될 채널 수입니다.
num_point_embeddings (`int`, *선택 사항*, 기본값 4) : 사용할 포인트 임베딩의 개수입니다.
hidden_act (`str`, *선택 사항*, 기본값 `gelu`) : 디코더에서 사용되는 비선형 활성화 함수(함수 또는 문자열). 예를 들어, `"gelu"`, `"relu"`, `"silu"` 등이 있습니다.
layer_norm_eps (`float`, *선택 사항*, 기본값 `1e-06`) : 레이어 정규화 레이어에서 사용되는 epsilon 값입니다.
이것은 SamModel의 구성을 저장하기 위한 구성 클래스입니다. 지정된 인자에 따라 Sam 모델을 인스턴스화하여 모델 아키텍처를 정의하는 데 사용됩니다. 기본값으로 구성을 인스턴스화하면 [facebook/sam-vit-huge](https://huggingface.co/facebook/sam-vit-huge)와 유사한 구성이 생성됩니다.
Configuration 객체는 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)를 상속하며, 모델 출력을 제어하는 데 사용할 수 있습니다. 자세한 내용은 [PreTrainedConfig](/docs/transformers/main/ko/main_classes/configuration#transformers.PreTrainedConfig)의 문서를 참고하세요.
## SamProcessor[[transformers.SamProcessor]]
#### transformers.SamProcessor[[transformers.SamProcessor]]
```python
transformers.SamProcessor(image_processor)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/processing_sam.py#L93)
**매개변수:**
image_processor (`SamImageProcessor`) : 이미지 프로세서가 필수 입력입니다.
이미지 프로세서를 단일 프로세서로 감싸는 SamProcessor를 생성합니다.
[SamProcessor](/docs/transformers/main/ko/model_doc/sam#transformers.SamProcessor)는 [SamImageProcessor](/docs/transformers/main/ko/model_doc/sam#transformers.SamImageProcessor)의 모든 기능을 제공합니다. 자세한 내용은 [~SamImageProcessor](/docs/transformers/main/ko/model_doc/sam#transformers.SamImageProcessor)를 참고하세요.
#### __call__[[transformers.SamProcessor.__call__]]
```python
__call__(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, text: str | list[str] | list[list[str]] | None = None, segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, input_points: NestedList | torch.Tensor | None = None, input_labels: NestedList | int | torch.Tensor | None = None, input_boxes: NestedList | torch.Tensor | None = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/processing_sam.py#L102)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`, *선택*) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
text (`Union[str, list[str], list[list[str]]]`, *선택*) : 인코딩할 시퀀스 또는 시퀀스 배치입니다. 각 시퀀스는 문자열 또는 문자열 목록(사전 토큰화된 문자열)일 수 있습니다. 사전 토큰화된 입력을 전달하는 경우, 배치 입력과의 혼동을 피하기 위해 `is_split_into_words=True`를 설정하세요.
segmentation_maps (`ImageInput`, *선택 사항*) : 입력 이미지와 함께 처리할 ground truth segmentation map입니다. 이 map은 학습 또는 평가 목적으로 사용되며, 처리된 이미지의 차원에 맞게 리사이즈 및 정규화됩니다.
input_points (`NestedList`, *선택 사항*) : 프롬프트 기반 분할을 위한 입력 점. 각 점은 원본 이미지 공간에서 `[x, y]` 좌표로 지정되며, 구조가 `[image_level, object_level, point_level, [x, y]]`인 중첩 리스트여야 합니다. 점은 모델에 전달되기 전에 대상 이미지 크기로 정규화됩니다.
input_labels (`NestedList`, *선택 사항*) : 입력 포인트의 라벨로, 각 포인트가 전경(1)인지 배경(0)인지를 나타냅니다. `[image_level, object_level, point_level]` 구조를 가진 중첩 리스트여야 합니다. `input_points`와 동일한 구조여야 합니다(좌표 차원을 제외).
input_boxes (`NestedList`, *선택 사항*) : 프롬프트 기반 분할을 위한 바운딩 박스. 각 박스가 원본 이미지 공간에서 `[x1, y1, x2, y2]` 좌표로 지정된 `[image_level, box_level, [x1, y1, x2, y2]]` 구조의 중첩 리스트여야 합니다. 박스는 모델에 전달되기 전에 대상 이미지 크기로 정규화됩니다.
segmentation_maps (`ImageInput`, *kwargs*, *선택*) : 비추천됩니다. 대신 [SamProcessor.__call__()](/docs/transformers/main/ko/model_doc/sam#transformers.SamProcessor.__call__)에 `segmentation_maps`로 직접 전달하세요. 입력 이미지와 함께 처리할 ground truth segmentation map입니다. 이 map은 학습 또는 평가 목적으로 사용되며, 처리된 이미지의 차원에 맞게 리사이즈 및 정규화됩니다.
input_points (`NestedList`, *kwargs*, *optional*) : 비추천됩니다. 대신 [SamProcessor.__call__()](/docs/transformers/main/ko/model_doc/sam#transformers.SamProcessor.__call__)에 `input_points`로 직접 전달하세요. 프롬프트 기반 분할을 위한 입력 점입니다. 원래 이미지 공간에서 각 점을 `[x, y]` 좌표로 지정하는 `[image_level, object_level, point_level, [x, y]]` 구조의 중첩 리스트여야 합니다. 점은 모델에 전달되기 전에 대상 이미지 크기로 정규화됩니다.
input_labels (`NestedList`, *kwargs*, *선택*) : 비추천됩니다. 대신 [SamProcessor.__call__()](/docs/transformers/main/ko/model_doc/sam#transformers.SamProcessor.__call__)에 `input_labels`로 직접 전달하세요. 입력 포인트의 라벨로, 각 포인트가 전경(1)인지 배경(0)인지를 나타냅니다. `[image_level, object_level, point_level]` 구조를 가진 중첩 리스트여야 합니다. `input_points`와 동일한 구조여야 합니다(좌표 차원을 제외).
input_boxes (`NestedList`, *kwargs*, *optional*) : 비추천됩니다. 대신 [SamProcessor.__call__()](/docs/transformers/main/ko/model_doc/sam#transformers.SamProcessor.__call__)에 `input_boxes`로 직접 전달하세요. 프롬프트 기반 분할을 위한 바운딩 박스입니다. 각 박스가 원본 이미지 공간에서 `[x1, y1, x2, y2]` 좌표로 지정된 `[image_level, box_level, [x1, y1, x2, y2]]` 구조의 중첩 리스트여야 합니다. 박스는 모델에 전달되기 전에 대상 이미지 크기로 정규화됩니다.
point_pad_value (`int`, *kwargs*, *optional*) : 비추천됩니다. 대신 `SamProcessorKwargs.point_pad_value`를 사용하세요. 서로 다른 길이의 시퀀스를 배치할 때 입력 포인트를 패딩하는 데 사용되는 값입니다. 이 값은 패딩된 위치를 표시하며, 좌표 정규화 과정에서 유지되어 실제 포인트와 패딩을 구별합니다.
mask_size (`dict[str, *kwargs*, int]`, *선택 사항*) : `"height"`와 `"width"` 키를 사용하여 대상 마스크 크기를 지정하는 사전입니다. 이는 모델이 생성하는 출력 분할 마스크의 해상도를 결정합니다.
mask_pad_size (`dict[str, *kwargs*, int]`, *선택 사항*) : `"height"`와 `"width"` 키를 사용하여 마스크의 패딩 크기를 지정하는 사전입니다. 서로 다른 크기의 마스크를 배치할 때 일관된 차원을 보장하기 위해 사용됩니다.
return_mm_token_type_ids (`bool`, *kwargs*) : 멀티모달 플레이스홀더 토큰의 위치를 나타내는 멀티모달 토큰 타입 ID를 반환할지 여부.
return_text_replacement_offsets (`bool`, *kwargs*) : 각 멀티모달 플레이스홀더 및 그 대체 문자열의 문자 오프셋을 반환할지 여부.
point_pad_value (`int`, *kwargs*, *선택 사항*, 기본값 `-10`) : 서로 다른 길이의 시퀀스를 배치할 때 입력 포인트를 패딩하는 데 사용되는 값입니다. 이 값은 패딩된 위치를 표시하며, 좌표 정규화 과정에서 유지되어 실제 포인트와 패딩을 구별합니다.
return_tensors (`str` 또는 [TensorType](/docs/transformers/main/ko/internal/file_utils#transformers.TensorType), *optional*) : 설정된 경우, 특정 프레임워크의 텐서를 반환합니다. 허용되는 값은 다음과 같습니다: - `'pt'`: PyTorch `torch.Tensor` 객체를 반환합니다. - `'np'`: NumPy `np.ndarray` 객체를 반환합니다.
- ****kwargs** ([ProcessingKwargs](/docs/transformers/main/ko/main_classes/processors#transformers.ProcessingKwargs), *optional*) : 각 모달리티(텍스트, 이미지, 비디오, 오디오)에 대한 추가 처리 옵션입니다. 모델별 매개변수는 위에 나열되어 있으며, 지원되는 인수의 전체 목록은 TypedDict 클래스를 참조하세요.
**반환값:** `~tokenization_utils_base.BatchEncoding`
- **data** (`dict`, *선택 사항*) -- `__call__`/`encode_plus`/`batch_encode_plus` 메서드가 반환하는 리스트/배열/텐서 딕셔너리('input_ids', 'attention_mask' 등).
- **encoding** (`tokenizers.Encoding` 또는 `Sequence[tokenizers.Encoding]`, *선택 사항*) -- 토크나이저가 워드/문자 공간에서 토큰 공간으로의 매핑과 같은 추가 정보를 출력하는 fast tokenizer인 경우, `tokenizers.Encoding` 인스턴스 또는 인스턴스 목록(배치의 경우)에 이 정보가 저장됩니다.
- **tensor_type** (`Union[None, str, TensorType]`, *선택 사항*) -- 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type을 지정할 수 있습니다.
- **prepend_batch_axis** (`bool`, *선택 사항*, 기본값 `False`) -- 텐서로 변환할 때 배치 축을 추가할지 여부(위에서 설명한 `tensor_type` 참조). `tensor_type` 매개변수가 설정된 경우에만 이 매개변수가 효과를 가지며, *그렇지 않으면 효과가 없습니다*.
- **n_sequences** (`int`, *선택 사항*) -- 각 인코딩이 나타내는 입력 시퀀스의 수 (`None`은 미지, `1`은 단일 시퀀스, `2`는 시퀀스 쌍을 의미합니다).
## SamImageProcessor[[transformers.SamImageProcessor]]
#### transformers.SamImageProcessor[[transformers.SamImageProcessor]]
```python
transformers.SamImageProcessor(**kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_sam.py#L61)
**매개변수:**
do_convert_rgb (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, 기본값 `{'longest_edge' : 1024}`): 모델에 입력되는 최대 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : size가 int인 경우 리사이즈 시 정사각형 이미지로 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, 기본값 `2`) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. 이는 `PILImageResampling` enum 중 하나일 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택 사항*, 기본값 `0.00392156862745098`) : `do_rescale`이 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.485, 0.456, 0.406]`) : 정규화에 사용할 이미지 평균입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.229, 0.224, 0.225]`) : 정규화에 사용할 이미지 표준 편차입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaults to `{'height' : 1024, 'width': 1024}`): The size in `{"height": int, "width" int}` to pad the images to. Must be larger than any image size provided for preprocessing. If `pad_size` is not provided, images will be padded to the largest height and width in the batch. Applied only when `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
mask_size (`dict[str, *kwargs*, int]`, *선택 사항*) : 세그멘테이션 맵을 리사이즈할 크기 `{"longest_edge": int}`.
mask_pad_size (`dict[str, *kwargs*, int]`, *선택 사항*) : 분할 맵을 패딩할 크기 `{"height": int, "width": int}`입니다. 전처리용으로 제공된 모든 분할 맵 크기보다 커야 합니다.
SamImageProcessor 이미지 프로세서를 생성합니다.
#### preprocess[[transformers.SamImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_sam.py#L79)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
segmentation_maps (`ImageInput`, *선택 사항*) : 전처리할 분할 맵.
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택*) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 모델의 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택*) : size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택*) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택*) : `do_rescale`가 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택*) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 평균값. `do_normalize`이 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 표준 편차. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택*) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
mask_size (`dict[str, *kwargs*, int]`, *선택 사항*) : 세그멘테이션 맵을 리사이즈할 크기 `{"longest_edge": int}`.
mask_pad_size (`dict[str, *kwargs*, int]`, *선택 사항*) : 분할 맵을 패딩할 크기 `{"height": int, "width": int}`입니다. 전처리용으로 제공된 모든 분할 맵 크기보다 커야 합니다.
**반환값:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ 메서드가 반환하는 리스트/배열/텐서 딕셔너리('pixel_values' 등).
- **tensor_type** (`Union[None, str, TensorType]`, *선택 사항*) -- 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type을 지정할 수 있습니다.
## SamImageProcessorPil[[transformers.SamImageProcessorPil]]
#### transformers.SamImageProcessorPil[[transformers.SamImageProcessorPil]]
```python
transformers.SamImageProcessorPil(**kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_pil_sam.py#L82)
**매개변수:**
do_convert_rgb (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, 기본값 `{'longest_edge' : 1024}`): 모델에 입력되는 최대 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : size가 int인 경우 리사이즈 시 정사각형 이미지로 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, 기본값 `2`) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. 이는 `PILImageResampling` enum 중 하나일 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택 사항*, 기본값 `0.00392156862745098`) : `do_rescale`이 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.485, 0.456, 0.406]`) : 정규화에 사용할 이미지 평균입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택 사항*, 기본값은 `[0.229, 0.224, 0.225]`) : 정규화에 사용할 이미지 표준 편차입니다. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택 사항*, 기본값 `True`) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, defaults to `{'height' : 1024, 'width': 1024}`): The size in `{"height": int, "width" int}` to pad the images to. Must be larger than any image size provided for preprocessing. If `pad_size` is not provided, images will be padded to the largest height and width in the batch. Applied only when `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
mask_size (`dict[str, *kwargs*, int]`, *선택 사항*) : 세그멘테이션 맵을 리사이즈할 크기 `{"longest_edge": int}`.
mask_pad_size (`dict[str, *kwargs*, int]`, *선택 사항*) : 분할 맵을 패딩할 크기 `{"height": int, "width": int}`입니다. 전처리용으로 제공된 모든 분할 맵 크기보다 커야 합니다.
SamImageProcessor 이미지 프로세서를 생성합니다.
#### preprocess[[transformers.SamImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/image_processing_pil_sam.py#L100)
**매개변수:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : 전처리할 이미지. 픽셀 값이 0에서 255 범위로 이루어진 단일 이미지 또는 배치 이미지를 기대합니다. 픽셀 값이 0에서 1 범위로 이루어진 이미지를 전달하는 경우 `do_rescale=False`로 설정하세요.
segmentation_maps (`ImageInput`, *선택 사항*) : 전처리할 분할 맵.
do_convert_rgb (`bool`, *kwargs*, *선택*) : 이미지를 RGB로 변환할지 여부.
do_resize (`bool`, *kwargs*, *선택*) : 이미지를 리사이즈할지 여부.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 모델의 최대 입력 차원을 설명합니다.
default_to_square (`bool`, *kwargs*, *선택*) : size가 int인 경우 리사이즈 시 정사각형 이미지로 기본 설정할지 여부.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop`를 적용한 후의 출력 이미지 크기.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : 이미지를 리사이즈할 때 사용할 리샘플링 필터입니다. `PILImageResampling` enum 중 하나를 사용할 수 있습니다. `do_resize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_rescale (`bool`, *kwargs*, *선택*) : 이미지를 다시 스케일링할지 여부.
rescale_factor (`float`, *kwargs*, *선택*) : `do_rescale`가 `True`로 설정된 경우 이미지를 재조정하는 데 사용되는 재조정 계수입니다.
do_normalize (`bool`, *kwargs*, *선택*) : 이미지를 정규화할지 여부.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 평균값. `do_normalize`이 `True`로 설정된 경우에만 효과가 있습니다.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *선택*) : 정규화에 사용할 이미지 표준 편차. `do_normalize`가 `True`로 설정된 경우에만 효과가 있습니다.
do_pad (`bool`, *kwargs*, *선택*) : 이미지를 패딩할지 여부입니다. 패딩은 배치 내 가장 큰 크기로 수행하거나, 이미지마다 고정된 정사각형 크기로 수행합니다. 정확한 패딩 전략은 모델에 따라 달라집니다.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : 이미지를 패딩할 `{"height": int, "width" int}` 크기를 지정합니다. 전처리용으로 제공된 모든 이미지 크기보다 커야 합니다. `pad_size`가 제공되지 않으면, 이미지는 배치 내 가장 큰 높이와 너비로 패딩됩니다. `do_pad=True.`일 때만 적용됩니다.
do_center_crop (`bool`, *kwargs*, *선택*) : 이미지를 중앙 크롭할지 여부.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : `ChannelDimension.FIRST`만 지원됩니다. 느린 프로세서와의 호환성을 위해 추가되었습니다.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *선택*) : 입력 이미지의 채널 차원 형식입니다. 설정하지 않으면 입력 이미지에서 채널 차원 형식을 추론합니다. 다음 중 하나일 수 있습니다: - `"channels_first"` 또는 `ChannelDimension.FIRST`: (num_channels, height, width) 형식의 이미지. - `"channels_last"` 또는 `ChannelDimension.LAST`: (height, width, num_channels) 형식의 이미지. - `"none"` 또는 `ChannelDimension.NONE`: (height, width) 형식의 이미지.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : 비디오를 처리할 장치입니다. 설정되지 않은 경우, 입력 비디오에서 장치를 추론합니다.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'`로 설정된 경우 스택된 텐서를 반환하고, 그렇지 않으면 텐서 목록을 반환합니다.
disable_grouping (`bool`, *kwargs*, *선택*) : 이미지의 크기에 따른 그룹화를 비활성화하여 이미지를 배치 대신 개별적으로 처리할지 여부입니다. None인 경우, 이미지가 CPU에 있으면 True, 그렇지 않으면 False로 설정됩니다. 이 선택은 https://github.com/huggingface/transformers/pull/38157에 자세히 설명된 경험적 관찰에 기반합니다.
image_seq_length (`int`, *kwargs*, *선택*) : 입력의 각 이미지에 사용할 이미지 토큰의 수입니다. 하위 호환성을 위해 추가되었지만, 향후 모델에서는 프로세서 속성으로 설정해야 합니다.
mask_size (`dict[str, *kwargs*, int]`, *선택 사항*) : 세그멘테이션 맵을 리사이즈할 크기 `{"longest_edge": int}`.
mask_pad_size (`dict[str, *kwargs*, int]`, *선택 사항*) : 분할 맵을 패딩할 크기 `{"height": int, "width": int}`입니다. 전처리용으로 제공된 모든 분할 맵 크기보다 커야 합니다.
**반환값:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ 메서드가 반환하는 리스트/배열/텐서 딕셔너리('pixel_values' 등).
- **tensor_type** (`Union[None, str, TensorType]`, *선택 사항*) -- 초기화 시 PyTorch/Numpy 텐서에서 정수 목록을 변환하려면 여기에 tensor_type을 지정할 수 있습니다.
## SamVisionModel[[transformers.SamVisionModel]]
#### transformers.SamVisionModel[[transformers.SamVisionModel]]
```python
transformers.SamVisionModel(config: SamVisionConfig)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1081)
**매개변수:**
config ([SamVisionConfig](/docs/transformers/main/ko/model_doc/sam#transformers.SamVisionConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하면 모델과 관련된 가중치가 로드되지 않고 구성만 로드됩니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
Sam의 비전 모델로, 상단에 헤드나 투영이 없는 상태입니다.
이 모델은 [PreTrainedModel](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.SamVisionModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1093)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`, *선택 사항*) : 입력 이미지에 해당하는 텐서입니다. 픽셀 값은 [SamImageProcessor](/docs/transformers/main/ko/model_doc/sam#transformers.SamImageProcessor)를 사용하여 얻을 수 있습니다. 자세한 내용은 [SamImageProcessor.__call__()](/docs/transformers/main/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 ([SamProcessor](/docs/transformers/main/ko/model_doc/sam#transformers.SamProcessor)는 이미지 처리에 [SamImageProcessor](/docs/transformers/main/ko/model_doc/sam#transformers.SamImageProcessor)를 사용합니다).
**반환값:** `SamVisionEncoderOutput` 또는 `tuple(torch.Tensor)`
`SamVisionEncoderOutput` 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우)로, [SamConfig](/docs/transformers/main/ko/model_doc/sam#transformers.SamConfig) 및 입력에 따라 다양한 요소를 포함합니다.
[SamVisionModel](/docs/transformers/main/ko/model_doc/sam#transformers.SamVisionModel)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **image_embeds** (`torch.Tensor`, shape `(batch_size, output_dim)`, *선택*, 모델이 `with_projection=True`로 초기화되었을 때 반환) -- pooler_output에 projection layer를 적용하여 얻은 이미지 임베딩.
- **last_hidden_state** (`torch.Tensor`, shape `(batch_size, sequence_length, hidden_size)`, *선택 사항*) -- 모델의 마지막 레이어 출력에서 생성된 hidden-state 시퀀스입니다.
- **hidden_states** (`tuple[torch.Tensor, ...]`, *선택*, `output_hidden_states=True`가 전달되거나 `config.output_hidden_states=True`인 경우 반환) -- shape가 `(batch_size, sequence_length, hidden_size)`인 `torch.Tensor`의 튜플 (모델에 임베딩 레이어가 있는 경우 임베딩 출력 1개 + 각 레이어의 출력 1개).
각 레이어의 출력에서 모델의 Hidden-states와 선택적 초기 임베딩 출력을 포함합니다.
- **attentions** (`tuple[torch.Tensor, ...]`, *선택*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환) -- 각 레이어마다 하나씩 포함된 `torch.Tensor` 튜플로, shape는 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
## SamModel[[transformers.SamModel]]
#### transformers.SamModel[[transformers.SamModel]]
```python
transformers.SamModel(config: SamConfig)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1108)
**매개변수:**
config ([SamConfig](/docs/transformers/main/ko/model_doc/sam#transformers.SamConfig)) : 모델의 모든 매개변수를 포함하는 모델 구성 클래스입니다. 구성 파일로 초기화하는 것은 모델과 관련된 가중치를 로드하지 않으며, 구성 정보만 로드합니다. 모델 가중치를 로드하려면 [from_pretrained()](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel.from_pretrained) 메서드를 확인하세요.
입력 이미지와 입력 점 및 라벨, 박스 또는 마스크를 기반으로 분할 마스크를 생성하는 Segment Anything Model (SAM).
이 모델은 [PreTrainedModel](/docs/transformers/main/ko/main_classes/model#transformers.PreTrainedModel)에서 상속됩니다. 라이브러리가 모든 모델에 대해 구현하는 일반적 메서드(다운로드 또는 저장, 입력 임베딩 크기 조정, 헤드 프루닝 등)에 대해서는 상위 클래스 문서를 확인하세요.
이 모델은 또한 PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module)의 하위 클래스입니다. 일반적인 PyTorch Module처럼 사용하며, 일반적인 사용법과 동작에 관한 모든 사항은 PyTorch 문서를 참조하세요.
#### forward[[transformers.SamModel.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, input_points: typing.Optional[torch.Tensor] = None, input_labels: typing.Optional[torch.LongTensor] = None, input_boxes: typing.Optional[torch.Tensor] = None, input_masks: typing.Optional[torch.LongTensor] = None, image_embeddings: typing.Optional[torch.Tensor] = None, multimask_output: bool = True, attention_similarity: typing.Optional[torch.Tensor] = None, target_embedding: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[소스](https://github.com/huggingface/transformers/blob/main/src/transformers/models/sam/modeling_sam.py#L1191)
**매개변수:**
pixel_values (`torch.Tensor`, shape `(batch_size, num_channels, image_size, image_size)`, *선택 사항*) : 입력 이미지에 해당하는 텐서입니다. 픽셀 값은 [SamImageProcessor](/docs/transformers/main/ko/model_doc/sam#transformers.SamImageProcessor)를 사용하여 얻을 수 있습니다. 자세한 내용은 [SamImageProcessor.__call__()](/docs/transformers/main/ko/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__)를 참조하세요 ([SamProcessor](/docs/transformers/main/ko/model_doc/sam#transformers.SamProcessor)는 이미지 처리에 [SamImageProcessor](/docs/transformers/main/ko/model_doc/sam#transformers.SamImageProcessor)를 사용합니다).
input_points (`torch.Tensor`, shape `(batch_size, num_points, 2)`) : 입력 2D 공간 점입니다. prompt encoder가 프롬프트를 인코딩하는 데 사용되며, 일반적으로 훨씬 더 나은 결과를 제공합니다. 이 점들은 list of list of list를 processor에 전달하여 얻을 수 있으며, processor는 이에 해당하는 차원 4의 `torch` 텐서를 생성합니다. 첫 번째 차원은 이미지 배치 크기, 두 번째 차원은 점 배치 크기(즉, 입력 점당 모델이 예측할 세그멘테이션 마스크의 수), 세 번째 차원은 세그멘테이션 마스크당 점의 수(단일 마스크에 여러 점을 전달할 수 있음), 마지막 차원은 점의 x(수직) 및 y(수평) 좌표입니다. 이미지별로 또는 마스크별로 서로 다른 수의 점이 전달되는 경우, processor는 (0, 0) 좌표에 해당하는 "PAD" 점을 생성하고, labels를 사용하여 해당 점에 대한 임베딩 계산이 건너뜁니다.
input_labels (`torch.LongTensor`, shape `(batch_size, point_batch_size, num_points)`) : 포인트에 대한 입력 라벨입니다. 프롬프트 인코더가 프롬프트를 인코딩하는 데 사용됩니다. 공식 구현에 따르면 라벨은 3가지 유형이 있습니다. - `1`: 관심 대상 객체를 포함하는 포인트 - `0`: 관심 대상 객체를 포함하지 않는 포인트 - `-1`: 배경에 해당하는 포인트 다음 라벨을 추가했습니다. - `-10`: 패딩 포인트이므로 프롬프트 인코더가 무시해야 합니다 패딩 라벨은 프로세서가 자동으로 처리해야 합니다.
input_boxes (`torch.Tensor`, shape `(batch_size, num_boxes, 4)`) : 점들을 위한 입력 박스입니다. 프롬프트 인코더가 프롬프트를 인코딩하는 데 사용되며, 일반적으로 훨씬 더 나은 생성된 마스크를 제공합니다. 프로세서에 리스트의 리스트의 리스트를 전달하면 `torch` 텐서가 생성되며, 각 차원은 각각 이미지 배치 크기, 이미지당 박스 수, 박스의 왼쪽 위 및 오른쪽 아래 점의 좌표에 해당합니다. (`x1`, `y1`, `x2`, `y2`) 순서로: - `x1`: 입력 박스의 왼쪽 위 점의 x 좌표 - `y1`: 입력 박스의 왼쪽 위 점의 y 좌표 - `x2`: 입력 박스의 오른쪽 아래 점의 x 좌표 - `y2`: 입력 박스의 오른쪽 아래 점의 y 좌표
input_masks (`torch.Tensor`, shape `(batch_size, image_size, image_size)`) : SAM 모델은 세그멘테이션 마스크도 입력으로 받을 수 있습니다. 이 마스크는 prompt encoder에 의해 임베딩되어 해당하는 임베딩을 생성하며, 이후 mask decoder에 전달됩니다. 이 마스크들은 사용자가 수동으로 전달해야 하며, shape이 (`batch_size`, `image_size`, `image_size`)여야 합니다.
image_embeddings (`torch.Tensor`, shape `(batch_size, output_channels, window_size, window_size)`) : 이미지 임베딩입니다. 마스크 디코더가 마스크와 iou 점수를 생성하는 데 사용됩니다. 메모리 효율적인 계산을 위해, 사용자는 먼저 `get_image_embeddings` 메서드를 사용하여 이미지 임베딩을 가져온 다음, `pixel_values` 대신 이를 `forward` 메서드에 전달할 수 있습니다.
multimask_output (`bool`, *선택 사항*) : 원래 구현 및 논문에서는 모델이 항상 이미지당 3개의 마스크(해당하는 경우 점 또는 바운딩 박스당)를 출력합니다. 그러나 `multimask_output=False`를 지정하면 "최적"의 마스크에 해당하는 단일 마스크만 출력할 수 있습니다.
attention_similarity (`torch.Tensor`, *선택*) : [PerSAM](https://huggingface.co/papers/2305.03048)에서 소개된 개인화 용도로 모델이 사용되는 경우, target-guided attention을 위해 mask decoder에 제공되는 Attention 유사도 텐서.
target_embedding (`torch.Tensor`, *선택*) : [PerSAM](https://huggingface.co/papers/2305.03048)에서 소개된 개인화 용도로 모델이 사용되는 경우, mask decoder에 target-semantic prompting을 위해 제공되는 대상 개념의 임베딩입니다.
**반환값:** `SamImageSegmentationOutput` 또는 `tuple(torch.Tensor)`
구성([SamConfig](/docs/transformers/main/ko/model_doc/sam#transformers.SamConfig))과 입력에 따라 다양한 요소를 포함하는 `SamImageSegmentationOutput` 또는 `torch.Tensor`의 튜플(`return_dict=False`가 전달되거나 `config.return_dict=False`인 경우).
[SamModel](/docs/transformers/main/ko/model_doc/sam#transformers.SamModel)의 forward 메서드는 `__call__` 특수 메서드를 오버라이드합니다.
`Module` 인스턴스는 전처리 및 후처리 단계를 실행하는 것을 처리하지만, 이 함수는 해당 단계를 조용히 무시하므로, 순전파(forward pass) 레시피를 이 함수 내에서 정의해야 하더라도 이후에는 이 함수 대신 `Module` 인스턴스를 호출해야 합니다.
- **iou_scores** (`torch.Tensor`, shape `(batch_size, num_masks)`) -- 예측된 마스크의 iou 점수입니다.
- **pred_masks** (`torch.Tensor`, shape `(batch_size, num_masks, height, width)`) -- 예측된 저해상도 마스크입니다. 프로세서에 의해 후처리되어야 합니다.
- **vision_hidden_states** (`tuple(torch.Tensor)`, *선택 사항*, `output_hidden_states=True`가 전달되거나 `config.output_hidden_states=True`인 경우 반환됨) -- `torch.Tensor`의 튜플(모델에 임베딩 레이어가 있는 경우 임베딩의 출력에 대한 것 1개 + 각 레이어의 출력에 대한 것 1개)로, 모양은 `(batch_size, sequence_length, hidden_size)`입니다.
각 레이어의 출력에서 비전 모델의 Hidden-states와 선택적인 초기 임베딩 출력.
- **vision_attentions** (`tuple(torch.Tensor)`, *선택 사항*, `output_attentions=True`가 전달되거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
- **mask_decoder_attentions** (`tuple(torch.Tensor)`, *선택 사항*, `output_attentions=True`가 전달되었거나 `config.output_attentions=True`인 경우 반환됨) -- 각 레이어마다 하나씩 포함된 `torch.Tensor`의 튜플로, 모양은 `(batch_size, num_heads, sequence_length, sequence_length)`입니다.
self-attention 헤드에서 가중 평균을 계산하는 데 사용되는 attention softmax 이후의 attention 가중치입니다.
예:
```python
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> from transformers import AutoModel, AutoProcessor
>>> model = AutoModel.from_pretrained("facebook/sam-vit-base")
>>> processor = AutoProcessor.from_pretrained("facebook/sam-vit-base")
>>> url = "https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/transformers/model_doc/sam-car.png"
>>> with httpx.stream("GET", url) as response:
... raw_image = Image.open(BytesIO(response.read())).convert("RGB")
>>> input_points = [[[400, 650]]] # 2D location of a window on the car
>>> inputs = processor(images=raw_image, input_points=input_points, return_tensors="pt")
>>> # Get segmentation mask
>>> outputs = model(**inputs)
>>> # Postprocess masks
>>> masks = processor.post_process_masks(
... outputs.pred_masks, inputs["original_sizes"], inputs["reshaped_input_sizes"]
... )
```