# BEiT
## Genel Bakış
BEiT modeli, Hangbo Bao, Li Dong ve Furu Wei tarafından [BEiT: BERT Pre-Training of Image Transformers](https://huggingface.co/papers/2106.08254) makalesinde önerilmiştir. BERT'ten ilham alan BEiT, Görüntü Dönüşümcülerinin (ViT) kendiliğinden denetimli ön eğitiminin denetimli ön eğitimi geride bırakmasını sağlayan ilk makaledir. Modelin bir görüntünün sınıfını tahmin etmesi için ön eğitilmesi yerine ([orijinal ViT makalesinde](https://huggingface.co/papers/2010.11929) yapıldığı gibi), BEiT modelleri, maskelenmiş yamalar verildiğinde OpenAI'nin [DALL-E modelinin](https://huggingface.co/papers/2102.12092) sözlüğündeki görsel jetonları tahmin etmesi için ön eğitilir.
Makalenin özeti aşağıdaki gibidir:
*Bidirectional Encoder representation from Image Transformers (Görsel Dönüştürücülerden Çift Yönlü Kodlayıcı Temsilcisi) anlamına gelen BEiT adlı, kendiliğinden denetimli bir görü temsil modelini tanıtıyoruz. Doğal dil işleme alanında geliştirilen BERT'i takip ederek, görü Dönüştürücülerini ön eğitmek için maskeli görüntü modelleme görevi öneriyoruz. Özellikle, ön eğitimimizde her görüntünün iki görünümü vardır: görüntü yamaları (örneğin 16x16 piksel) ve görsel jetonlar (yani, ayrık jetonlar). Önce orijinal görüntüyü görsel jetonlara "dönüştürüyoruz". Ardından bazı görüntü yamalarını rastgele maskeliyoruz ve bunları omurga Dönüştürücüye (backbone Transformer) veriyoruz. Ön eğitimin amacı, bozulmuş görüntü yamalarına dayanarak orijinal görsel jetonları geri getirmektir. BEiT'i ön eğittikten sonra, ön eğitilmiş kodlayıcının üzerine görev katmanları ekleyerek model parametrelerini doğrudan aşağı akış görevlerinde ince ayarlıyoruz. Görüntü sınıflandırma ve anlamsal segmentasyon üzerindeki deneysel sonuçlar, modelimizin önceki ön eğitim yöntemleriyle rekabetçi sonuçlar elde ettiğini göstermektedir. Örneğin, taban boyutlu (base-size) BEiT, ImageNet-1K üzerinde %83,2 top-1 doğruluğa ulaşarak, aynı kurulumda sıfırdan yapılan DeiT eğitimini (%81,8) önemli ölçüde geride bırakmaktadır. Ayrıca, büyük boyutlu (large-size) BEiT, yalnızca ImageNet-1K kullanarak %86,3 doğruluk elde etmekte ve ImageNet-22K üzerinde denetimli ön eğitimi olan ViT-L'yi (%85,2) bile geride bırakmaktadır.*
Bu model [nielsr](https://huggingface.co/nielsr) tarafından katkıda bulunmuştur. Orijinal kod [burada](https://github.com/microsoft/unilm/tree/master/beit) bulunabilir.
## Kullanım ipuçları
- BEiT modelleri standart Vision Transformer'lerdir, ancak denetimli yerine kendiliğinden denetimli (self-supervised) bir şekilde ön eğitilirler. ImageNet-1K ve CIFAR-100 üzerinde ince ayar yapıldıklarında hem [orijinal model (ViT)](vit) hem de [Data-efficient Image Transformers (DeiT)](deit) modellerini geride bırakırlar. Çıkarım (inference) ve özel veriler üzerinde ince ayar ile ilgili demo defterlerine [buradan](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/VisionTransformer) erişebilirsiniz (yalnızca [ViTImageProcessor](/docs/transformers/main/tr/model_doc/vit#transformers.ViTImageProcessor) yerine [BeitImageProcessor](/docs/transformers/main/tr/model_doc/beit#transformers.BeitImageProcessor) ve [ViTForImageClassification](/docs/transformers/main/tr/model_doc/vit#transformers.ViTForImageClassification) yerine [BeitForImageClassification](/docs/transformers/main/tr/model_doc/beit#transformers.BeitForImageClassification) kullanmanız yeterlidir).
- DALL-E'nin görüntü belirteçleyicisini (tokenizer) BEiT ile birleştirerek maskeli görüntü modelleme (masked image modeling) yapmanın nasıl gerçekleştirileceğini gösteren bir demo defter de mevcuttur. Bunu [burada](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/BEiT) bulabilirsiniz.
- BEiT modelleri her görüntünün aynı boyutta (çözünürlükte) olmasını beklediğinden, görüntüleri model için yeniden boyutlandırmak (veya yeniden ölçeklemek) ve normalize etmek için [BeitImageProcessor](/docs/transformers/main/tr/model_doc/beit#transformers.BeitImageProcessor) kullanılabilir.
- Ön eğitim veya ince ayar sırasında kullanılan hem yama çözünürlüğü hem de görüntü çözünürlüğü, her kontrol noktasının adında yansıtılır. Örneğin, `microsoft/beit-base-patch16-224`, yama çözünürlüğü 16x16 ve ince ayar çözünürlüğü 224x224 olan temel boyutlu bir mimariye atıfta bulunur. Tüm kontrol noktaları [hub](https://huggingface.co/models?search=microsoft/beit)'da bulunabilir.
- Mevcut denetim noktaları (1) yalnızca [ImageNet-22k](http://www.image-net.org/) (14 milyon görüntü ve 22k sınıf içeren bir derleme) üzerinde ön eğitilmiş, (2) ImageNet-22k üzerinde ayrıca ince ayarlanmış veya (3) [ImageNet-1k](http://www.image-net.org/challenges/LSVRC/2012/) (ILSVRC 2012 olarak da bilinir, 1,3 milyon görüntü ve 1.000 sınıf içeren bir derleme) üzerinde ayrıca ince ayarlanmış olabilir.
- BEiT, T5 modelinden ilham alan göreli konum gömme (embedding) kullanır. Ön eğitim sırasında yazarlar, göreli konum sapmasını (bias) birden fazla öz-dikkat (self-attention) katmanı arasında paylaştırdı. İnce ayarlama sırasında, her katmanın göreli konum sapması, ön eğitimden sonra elde edilen paylaşılan göreli konum sapmasıyla başlatılır. Dikkat edin, sıfırdan bir model ön eğitmek isteniyorsa, konum gömme eklemek için [BeitConfig](/docs/transformers/main/tr/model_doc/beit#transformers.BeitConfig)'nin `use_relative_position_bias` veya `use_relative_position_bias` özniteliklerinden birinin `True` olarak ayarlanması gerekir.
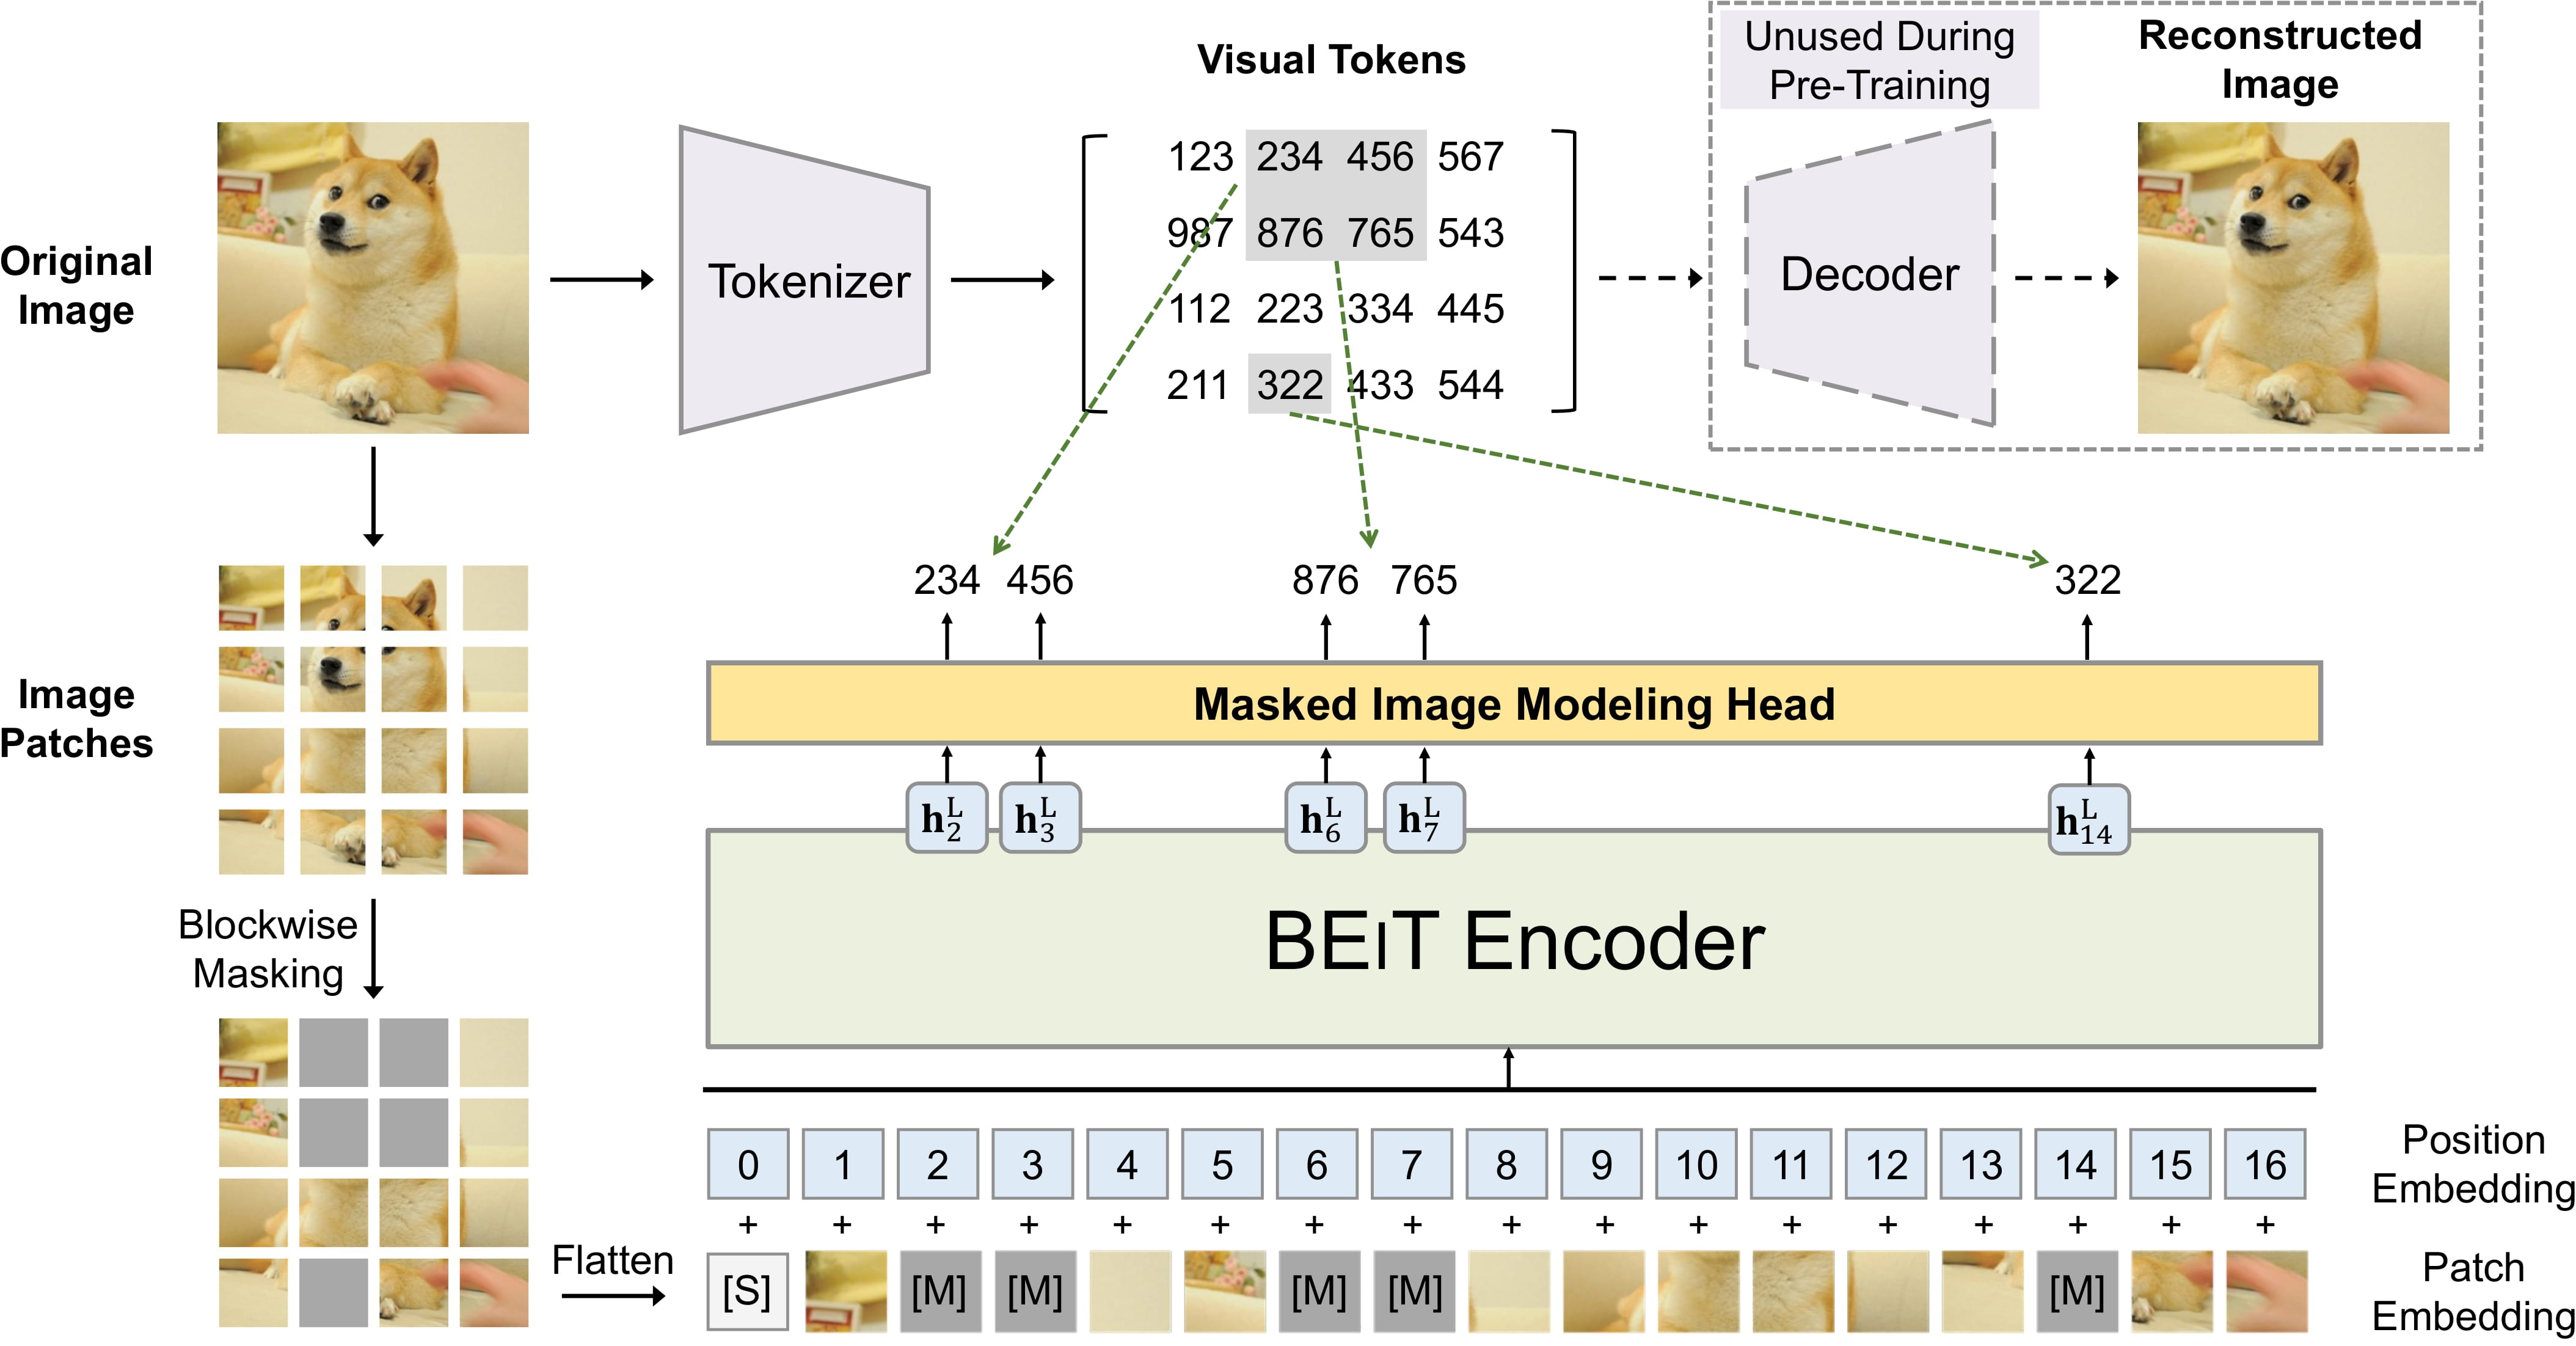 BEiT ön eğitimi. Orijinal makaleden alınmıştır.
### Ölçekli Nokta Çarpımı Dikkat (SDPA) Kullanımı
PyTorch, `torch.nn.functional` parçası olarak yerel ölçekli nokta çarpımı dikkati (SDPA) operatörünü içerir. Bu fonksiyon, girdilere ve kullanılan donanıma bağlı olarak uygulanabilecek çeşitli uygulamaları kapsar. Daha fazla bilgi için [resmi dokümantasyonu](https://pytorch.org/docs/stable/generated/torch.nn.functional.scaled_dot_product_attention.html) veya [GPU Inference](https://huggingface.co/docs/transformers/main/en/perf_infer_gpu_one#pytorch-scaled-dot-product-attention) sayfasına bakın.
`torch>=2.1.1` için bir uygulama mevcut olduğunda varsayılan olarak SDPA kullanılır, ancak SDPA'nın kullanılmasını açıkça istemek için `from_pretrained()` içinde `attn_implementation="sdpa"` ayarlayabilirsiniz.
```python
from transformers import BeitForImageClassification
model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224", attn_implementation="sdpa", device_map="auto")
...
```
En iyi hızlanmalar için, modelin yarım hassasiyette (ör. `torch.float16` veya `torch.bfloat16`) yüklenmesini öneririz.
Yerel bir benchmark'ta (NVIDIA GeForce RTX 2060-8GB, PyTorch 2.5.1, OS Ubuntu 20.04) `float16` ve `microsoft/beit-base-patch16-224` modeliyle eğitim ve çıkarım sırasında aşağıdaki iyileştirmeleri gözlemledik:
#### Eğitim
| num_training_steps | batch_size | image_size | is_cuda | Batch başına süre (eager - s) | Parti başına süre (sdpa - s) | Hızlanma (%) | Eager zirve bellek (MB) | SDPA zirve bellek (MB) | Bellek tasarrufu (%) |
|--------------------|------------|--------------|---------|----------------------------|---------------------------|-------------|----------------------|--------------------|----------------|
| 50 | 2 | (1048, 640) | True | 0.984 | 0.746 | 31.975 | 6738.915 | 4319.886 | 55.998 |
#### Çıkarım
| Görsel parti boyutu | Eager (s/iterasyon) | Eager CI, % | Eager bellek (MB) | SDPA (s/iter) | SDPA CI, % | SDPA belleği (MB) | SDPA hızlandırması | SDPA ile sağlanan bellek tasarrufu (%) |
|-------------------:|-----------------:|:--------------|--------------------:|----------------:|:-------------|-------------------:|---------------:|----------------------:|
| 1 | 0.012 | ±0.3% | 3.76657e+08 | 0.011 | ±0.5% | 3.75739e+08 | 1.05 | 0.244 |
| 4 | 0.013 | ±0.1% | 4.03147e+08 | 0.011 | ±0.2% | 3.90554e+08 | 1.178 | 3.225 |
| 16 | 0.045 | ±0.1% | 4.96697e+08 | 0.035 | ±0.1% | 4.51232e+08 | 1.304 | 10.076 |
| 32 | 0.088 | ±0.1% | 6.24417e+08 | 0.066 | ±0.1% | 5.33488e+08 | 1.325 | 17.044 |
## Kaynaklar
BEiT ile başlamanıza yardımcı olmak için resmi Hugging Face ve topluluk (🌎 ile belirtilen) kaynaklarının listesi.
- Bu [defter](https://colab.research.google.com/github/huggingface/notebooks/blob/main/examples/image_classification.ipynb) [BeitForImageClassification](/docs/transformers/main/tr/model_doc/beit#transformers.BeitForImageClassification) sınıfını destekler.
- Bkz: [Görsel sınıflandırma görevi kılavuzu](../tasks/image_classification)
**Anlamsal segmentasyon**
- [Anlamsal segmentasyon görevi kılavuzu](../tasks/semantic_segmentation)
Buraya bir kaynak eklemek isterseniz, lütfen bir Pull Request açmaktan çekinmeyin; inceleyeceğiz! Kaynağın, mevcut bir kaynağı tekrarlamak yerine ideal olarak yeni bir şeyi göstermesi beklenir.
## BEiT'e özgü çıktılar[[transformers.models.beit.modeling_beit.BeitModelOutputWithPooling]]
#### transformers.models.beit.modeling_beit.BeitModelOutputWithPooling[[transformers.models.beit.modeling_beit.BeitModelOutputWithPooling]]
```python
transformers.models.beit.modeling_beit.BeitModelOutputWithPooling(last_hidden_state: typing.Optional[torch.Tensor] = None, pooler_output: typing.Optional[torch.Tensor] = None, hidden_states: tuple[torch.Tensor, ...] | None = None, attentions: tuple[torch.Tensor, ...] | None = None)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L54)
**Parametreler:**
last_hidden_state (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) : Modelin son katmanının çıktısındaki gizli durumlar dizisi.
pooler_output (`torch.Tensor`, şekli `(batch_size, hidden_size)`) : *config.use_mean_pooling* True olarak ayarlanmışsa, yama tokenlarının son katman gizli durumlarının ortalaması (*[CLS]* token hariç). False olarak ayarlanmışsa, *[CLS]* tokenının son gizli durumu döndürülür.
hidden_states (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) : `torch.Tensor` (modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için birer tane) içeren bir demet, şekli `(batch_size, sequence_length, hidden_size)`. Modelin her katmanının çıktısındaki gizli durumlar ve isteğe bağlı başlangıç gömme çıktıları.
attentions (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) : `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`. Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
[BeitModel](/docs/transformers/main/tr/model_doc/beit#transformers.BeitModel) çıktılarının sınıfı.
## BeitConfig[[transformers.BeitConfig]]
#### transformers.BeitConfig[[transformers.BeitConfig]]
```python
transformers.BeitConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 8192, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.0, attention_probs_dropout_prob: float | int = 0.0, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, image_size: int | list[int] | tuple[int, int] = 224, patch_size: int | list[int] | tuple[int, int] = 16, num_channels: int = 3, use_mask_token: bool = False, use_absolute_position_embeddings: bool = False, use_relative_position_bias: bool = False, use_shared_relative_position_bias: bool = False, layer_scale_init_value: float = 0.1, drop_path_rate: float | int = 0.1, use_mean_pooling: bool = True, pool_scales: list[int] | tuple[int, ...] = (1, 2, 3, 6), use_auxiliary_head: bool = True, auxiliary_loss_weight: float = 0.4, auxiliary_channels: int = 256, auxiliary_num_convs: int = 1, auxiliary_concat_input: bool = False, semantic_loss_ignore_index: int = 255, _out_features: list[str] | None = None, _out_indices: list[int] | None = None, add_fpn: bool = False, reshape_hidden_states: bool = True)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/configuration_beit.py#L25)
**Parametreler:**
vocab_size (`int`, *isteğe bağlı*, varsayılan `8192`) : Modelin sözlük boyutu. `input_ids` tarafından temsil edilebilecek farklı token sayısını tanımlar.
hidden_size (`int`, *isteğe bağlı*, varsayılan `768`) : Gizli temsillerin boyutu.
num_hidden_layers (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki gizli katman sayısı.
num_attention_heads (`int`, *isteğe bağlı*, varsayılan `12`) : Transformer decoder'ındaki her dikkat katmanı için dikkat başı sayısı.
intermediate_size (`int`, *isteğe bağlı*, varsayılan `3072`) : MLP temsil boyutu.
hidden_act (`str`, *isteğe bağlı*, varsayılan `gelu`) : Çözücüdeki doğrusal olmayan aktivasyon fonksiyonu (fonksiyon veya dize). Örneğin, `"gelu"`, `"relu"`, `"silu"` vb.
hidden_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Gömme, kodlayıcı ve havuzlayıcıdaki tüm tam bağlı katmanlar için dropout olasılığı.
attention_probs_dropout_prob (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.0`) : Dikkat olasılıkları için dropout oranı.
initializer_range (`float`, *opsiyonel*, varsayılan `0.02`) : Tüm ağırlık matrislerini başlatmak için kullanılan truncated_normal_initializer'ın standart sapması.
layer_norm_eps (`float`, *opsiyonel*, varsayılan `1e-12`) : Katman normalizasyonu katmanları tarafından kullanılan epsilon.
image_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `224`) : Her bir görüntünün boyutu (çözünürlüğü).
patch_size (`Union[int, list[int], tuple[int, int]]`, *isteğe bağlı*, varsayılan `16`) : Her yamanın boyutu (çözünürlüğü).
num_channels (`int`, *opsiyonel*, varsayılan `3`) : Girdi kanal sayısı.
use_mask_token (`bool`, *isteğe bağlı*, varsayılan `False`) : Maskeli görüntü modelleme için bir maske jetonu kullanılıp kullanılmayacağı.
use_absolute_position_embeddings (`bool`, *isteğe bağlı*, varsayılan `False`) : Mutlak konum gömme kullanılıp kullanılmayacağı.
use_relative_position_bias (`bool`, *isteğe bağlı*, varsayılan `False`) : Kendi dikkat katmanlarında T5 tarzı göreli konum gömme kullanılıp kullanılmayacağı.
use_shared_relative_position_bias (`bool`, *isteğe bağlı*, varsayılan `False`) : Transformer'ın tüm öz-dikkat katmanlarında aynı göreli konum gömme (embedding) değerlerinin kullanılıp kullanılmayacağını belirtir.
layer_scale_init_value (`float`, *opsiyonel*, varsayılan `0.1`) : Kendi dikkat (self-attention) katmanlarında kullanılacak ölçek. Baz modeller için 0.1, büyük modeller için 1e-6. Katman ölçeklemeyi devre dışı bırakmak için 0 olarak ayarlayın.
drop_path_rate (`Union[float, int]`, *isteğe bağlı*, varsayılan `0.1`) : Yama birleştirme için drop path oranı.
use_mean_pooling (`bool`, *isteğe bağlı*, varsayılan `True`) : Sınıflandırma başlığı uygulanmadan önce, CLS token'ının son gizli durumunu kullanmak yerine yamaların son gizli durumlarının ortalama havuzlamasını (mean pooling) yapılıp yapılmayacağını belirtir.
pool_scales (`tuple[int]`, *opsiyonel*, varsayılan `[1, 2, 3, 6]`) : Son özellik haritasına uygulanan Pooling Pyramid Module'de kullanılan havuzlama ölçekleri.
use_auxiliary_head (`bool`, *isteğe bağlı*, varsayılan `True`) : Eğitim sırasında yardımcı bir başlık kullanılıp kullanılmayacağı.
auxiliary_loss_weight (`float`, *opsiyonel*, varsayılan 0.4) : Yardımcı başın çapraz entropi kaybının ağırlığı.
auxiliary_channels (`int`, *isteğe bağlı*, varsayılan 256) : Yardımcı başlıkta kullanılacak kanal sayısı.
auxiliary_num_convs (`int`, *isteğe bağlı*, varsayılan 1) : Yardımcı başlıkta kullanılacak konvolüsyon katmanlarının sayısı.
auxiliary_concat_input (`bool`, *isteğe bağlı*, varsayılan `False`) : Sınıflandırma katmanından önce yardımcı başlığın çıktısının girdiyle birleştirilip birleştirilmeyeceğini belirtir.
semantic_loss_ignore_index (`int`, *opsiyonel*, varsayılan `255`) : Semantik segmentasyon modelinin kayıp fonksiyonu tarafından yoksayılan indeks.
add_fpn (`bool`, *isteğe bağlı*, varsayılan `False`) : Omurganın bir parçası olarak FPN eklenip eklenmeyeceğini belirtir. Yalnızca `BeitBackbone` için geçerlidir.
reshape_hidden_states (`bool`, *isteğe bağlı*, varsayılan `True`) : Model bir omurga (backbone) olarak kullanılıyorsa, özellik haritalarının `(batch_size, hidden_size, height, width)` biçiminde 4B tensörlere yeniden şekillendirilip şekillendirilmeyeceğini belirtir. `False` ise, özellik haritaları `(batch_size, seq_len, hidden_size)` biçiminde 3B tensörler olur. Yalnızca `BeitBackbone` için geçerlidir.
Bu, bir BeitModel yapılandırmasını depolamak için kullanılan yapılandırma sınıfıdır. Belirtilen argümanlara göre bir Beit modelini örneklemek ve model mimarisini tanımlamak için kullanılır. Varsayılanlarla bir yapılandırma örneği oluşturmak, [microsoft/beit-base-patch16-224-pt22k](https://huggingface.co/microsoft/beit-base-patch16-224-pt22k) modelinin yapılandırmasına benzer bir yapılandırma üretir.
Yapılandırma nesneleri [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) sınıfından türetilir ve model çıktılarını kontrol etmek için kullanılabilir. Daha fazla bilgi için [PreTrainedConfig](/docs/transformers/main/tr/main_classes/configuration#transformers.PreTrainedConfig) belgesini okuyun.
Örnek:
```python
>>> from transformers import BeitConfig, BeitModel
>>> # Initializing a BEiT beit-base-patch16-224-pt22k style configuration
>>> configuration = BeitConfig()
>>> # Initializing a model (with random weights) from the beit-base-patch16-224-pt22k style configuration
>>> model = BeitModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## BeitImageProcessor[[transformers.BeitImageProcessor]]
#### transformers.BeitImageProcessor[[transformers.BeitImageProcessor]]
```python
transformers.BeitImageProcessor(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_beit.py#L50)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 224, 'width': 224}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 224, 'width': 224}`): `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `3`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.5, 0.5, 0.5]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.5, 0.5, 0.5]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
do_reduce_labels (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_reduce_labels`) : Segmentasyon haritalarındaki tüm etiket değerlerinin 1 azaltılacak mı. Genellikle 0'ın arka plan için kullanıldığı ve arka planın bir veri setindeki tüm sınıflara dahil olmadığı veri setlerinde (ör. ADE20k) kullanılır. Arka plan etiketi 255 ile değiştirilecektir.
Bir BeitImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.BeitImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_beit.py#L70)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
segmentation_maps (`ImageInput`, *isteğe bağlı*) : Ön işleme tabi tutulacak segmentasyon haritaları.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
do_reduce_labels (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_reduce_labels`) : Segmentasyon haritalarındaki tüm etiket değerlerinin 1 azaltılacak mı. Genellikle 0'ın arka plan için kullanıldığı ve arka planın bir veri setindeki tüm sınıflara dahil olmadığı veri setlerinde (ör. ADE20k) kullanılır. Arka plan etiketi 255 ile değiştirilecektir.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
#### post_process_semantic_segmentation[[transformers.BeitImageProcessor.post_process_semantic_segmentation]]
```python
post_process_semantic_segmentation(outputs, target_sizes: list[tuple] | None = None, return_segmentation_scores: bool = False)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_beit.py#L183)
**Parametreler:**
outputs ([BeitForSemanticSegmentation](/docs/transformers/main/tr/model_doc/beit#transformers.BeitForSemanticSegmentation)) : Modelin ham çıktıları.
target_sizes (`list[Tuple]`, uzunluğu `batch_size`, *isteğe bağlı*) : Her tahminin istenen nihai boyutuna (yükseklik, genişlik) karşılık gelen demetlerin listesi. Ayarlanmazsa, tahminler yeniden boyutlandırılmaz.
return_segmentation_scores (`bool`, *isteğe bağlı*, varsayılan `False`) : Segmentasyon haritasının yanı sıra segmentasyon puanlarının da döndürülüp döndürülmeyeceğini belirtir. `True` olduğunda, döndürülen listenin her öğesi `segmentation` (sınıf kimlikleri, şekil `(height, width)`) ve `segmentation_scores` (şekil `(num_classes, height, width)`) alanlarına sahip bir `SemanticSegmentationPostProcessorOutput` nesnesidir.
**Dönüş:** `list[torch.Tensor]` veya `list[SemanticSegmentationPostProcessorOutput]`
`return_segmentation_scores=False` (varsayılan) olduğunda, her öğesi sınıf kimliklerine sahip, `(height, width)` biçiminde bir segmentasyon haritası olan, uzunluğu `batch_size` olan bir liste döndürülür. `return_segmentation_scores=True` olduğunda, `segmentation` (sınıf kimlikleri, `(height, width)` biçimi) ve `segmentation_scores` (`(num_classes, height, width)` biçimi) alanlarına sahip `SemanticSegmentationPostProcessorOutput` nesnelerinden oluşan bir liste döndürülür. Her iki durumda da `(height, width)`, hedef boyuta (`target_sizes` belirtilmişse) karşılık gelir.
[BeitForSemanticSegmentation](/docs/transformers/main/tr/model_doc/beit#transformers.BeitForSemanticSegmentation) çıktısını anlamsal segmentasyon haritalarına dönüştürür.
## BeitImageProcessorPil[[transformers.BeitImageProcessorPil]]
#### transformers.BeitImageProcessorPil[[transformers.BeitImageProcessorPil]]
```python
transformers.BeitImageProcessorPil(**kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_pil_beit.py#L53)
**Parametreler:**
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 224, 'width': 224}`): Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görüntü kullanılıp kullanılmayacağını belirtir.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, varsayılan `{'height' : 224, 'width': 224}`): `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, varsayılan `3`) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*, varsayılan `0.00392156862745098`) : `do_rescale` `True` olarak ayarlandığında görüntüyü yeniden ölçeklemek için kullanılan yeniden ölçekleme faktörü.
do_normalize (`bool`, *kwargs*, *opsiyonel*, varsayılan `True`) : Görselin normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.5, 0.5, 0.5]`) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*, varsayılan `[0.5, 0.5, 0.5]`) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*, varsayılan `False`) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
do_reduce_labels (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_reduce_labels`) : Segmentasyon haritalarındaki tüm etiket değerlerinin 1 azaltılacak mı. Genellikle 0'ın arka plan için kullanıldığı ve arka planın bir veri setindeki tüm sınıflara dahil olmadığı veri setlerinde (ör. ADE20k) kullanılır. Arka plan etiketi 255 ile değiştirilecektir.
Bir BeitImageProcessor görüntü işleyicisi oluşturur.
#### preprocess[[transformers.BeitImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], segmentation_maps: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor'], NoneType] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_pil_beit.py#L73)
**Parametreler:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Ön işlenecek görüntü. Piksel değerleri 0 ile 255 arasında değişen tek bir görüntü veya görüntü grubu beklenir. Piksel değerleri 0 ile 1 arasında olan görüntüler geçiriliyorsa `do_rescale=False` olarak ayarlayın.
segmentation_maps (`ImageInput`, *isteğe bağlı*) : Ön işleme tabi tutulacak segmentasyon haritaları.
do_convert_rgb (`bool`, *kwargs*, *isteğe bağlı*) : Görselin RGB'ye dönüştürülüp dönüştürülmeyeceği.
do_resize (`bool`, *kwargs*, *isteğe bağlı*) : Görselin yeniden boyutlandırılıp boyutlandırılmayacağı.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Modelin kabul ettiği maksimum giriş boyutlarını açıklar.
default_to_square (`bool`, *kwargs*, *opsiyonel*) : Boyut bir int ise, yeniden boyutlandırma sırasında varsayılan olarak kare bir görsel kullanılıp kullanılmayacağı.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : `center_crop` uygulandıktan sonra çıktı görüntüsünün boyutu.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Görsel yeniden boyutlandırılıyorsa kullanılacak yeniden örnekleme filtresi. Bu, `PILImageResampling` enum değerlerinden biri olabilir. Yalnızca `do_resize` `True` olarak ayarlanırsa etkilidir.
do_rescale (`bool`, *kwargs*, *opsiyonel*) : Görselin yeniden ölçeklendirilip ölçeklendirilmeyeceğini belirtir.
rescale_factor (`float`, *kwargs*, *opsiyonel*) : `do_rescale` `True` olarak ayarlanırsa görüntüyü yeniden ölçeklemek için yeniden ölçekleme çarpanı.
do_normalize (`bool`, *kwargs*, *isteğe bağlı*) : Görüntünün normalize edilip edilmeyeceğini belirtir.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü ortalaması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opsiyonel*) : Normalizasyon için kullanılacak görüntü standart sapması. Yalnızca `do_normalize` `True` olarak ayarlanırsa etkilidir.
do_pad (`bool`, *kwargs*, *isteğe bağlı*) : Görselin dolgu (padding) uygulanıp uygulanmayacağını belirtir. Dolgu, ya batch içindeki en büyük boyuta ya da görsel başına sabit bir kare boyuta yapılır. Kesin dolgu stratejisi modele bağlıdır.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Görsellerin doldurulacağı boyut, `{"height": int, "width" int}` biçiminde. Ön işleme için sağlanan herhangi bir görsel boyutundan büyük olmalıdır. `pad_size` sağlanmazsa, görseller partideki en büyük yüksekliğe ve genişliğe doldurulur. Yalnızca `do_pad=True.` olduğunda uygulanır.
do_center_crop (`bool`, *kwargs*, *opsiyonel*) : Görselin merkezden kırpılıp kırpılmayacağını belirtir.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Yalnızca `ChannelDimension.FIRST` desteklenir. Yavaş işleyicilerle uyumluluk için eklendi.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *isteğe bağlı*) : Girdi görüntüsünün kanal boyutu biçimi. Ayarlanmazsa, kanal boyutu biçimi girdi görüntüsünden çıkarılır. Aşağıdakilerden biri olabilir: - `"channels_first"` veya `ChannelDimension.FIRST`: (num_channels, height, width) biçiminde görüntü. - `"channels_last"` veya `ChannelDimension.LAST`: (height, width, num_channels) biçiminde görüntü. - `"none"` veya `ChannelDimension.NONE`: (height, width) biçiminde görüntü.
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : Videoların işleneceği cihaz. Ayarlanmamışsa, cihaz girdi videolarından çıkarılır.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : `'pt'` olarak ayarlanırsa yığılmış tensörleri, aksi halde tensör listesi döndürür.
disable_grouping (`bool`, *kwargs*, *opsiyonel*) : Görsellerin boyuta göre gruplandırılmasını devre dışı bırakarak bunların toplu olarak değil, tek tek işlenmesini sağlar. None ise, görseller CPU üzerindeyse True, aksi halde False olarak ayarlanır. Bu seçim, buradaki ayrıntılı açıklamalara dayalı ampirik gözlemlere dayanmaktadır: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *isteğe bağlı*) : Girdideki her görüntü için kullanılacak görüntü jetonlarının sayısı. Geriye dönük uyumluluk için eklendi ancak bu, gelecekteki modellerde bir işlemci özniteliği olarak ayarlanmalıdır.
do_reduce_labels (`bool`, *kwargs*, *opsiyonel*, varsayılan `self.do_reduce_labels`) : Segmentasyon haritalarındaki tüm etiket değerlerinin 1 azaltılacak mı. Genellikle 0'ın arka plan için kullanıldığı ve arka planın bir veri setindeki tüm sınıflara dahil olmadığı veri setlerinde (ör. ADE20k) kullanılır. Arka plan etiketi 255 ile değiştirilecektir.
**Dönüş:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- __call__ yönteminin döndürdüğü listeler/diziler/tensörler sözlüğü ('pixel_values' vb.).
- **tensor_type** (`Union[None, str, TensorType]`, *isteğe bağlı*) -- Başlatma sırasında PyTorch/Numpy Tensörlerindeki tamsayı listelerini dönüştürmek için burada bir tensor_type verebilirsiniz.
#### post_process_semantic_segmentation[[transformers.BeitImageProcessorPil.post_process_semantic_segmentation]]
```python
post_process_semantic_segmentation(outputs, target_sizes: list[tuple] | None = None, return_segmentation_scores: bool = False)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/image_processing_pil_beit.py#L169)
**Parametreler:**
outputs ([BeitForSemanticSegmentation](/docs/transformers/main/tr/model_doc/beit#transformers.BeitForSemanticSegmentation)) : Modelin ham çıktıları.
target_sizes (`list[Tuple]`, uzunluğu `batch_size`, *isteğe bağlı*) : Her tahminin istenen nihai boyutuna (yükseklik, genişlik) karşılık gelen demetlerin listesi. Ayarlanmazsa, tahminler yeniden boyutlandırılmaz.
return_segmentation_scores (`bool`, *isteğe bağlı*, varsayılan `False`) : Segmentasyon haritasının yanı sıra segmentasyon puanlarının da döndürülüp döndürülmeyeceğini belirtir. `True` olduğunda, döndürülen listenin her öğesi `segmentation` (sınıf kimlikleri, şekil `(height, width)`) ve `segmentation_scores` (şekil `(num_classes, height, width)`) alanlarına sahip bir `SemanticSegmentationPostProcessorOutput` nesnesidir.
**Dönüş:** `list[torch.Tensor]` veya `list[SemanticSegmentationPostProcessorOutput]`
`return_segmentation_scores=False` (varsayılan) olduğunda, her öğesi sınıf kimliklerine sahip, `(height, width)` biçiminde bir segmentasyon haritası olan, uzunluğu `batch_size` olan bir liste döndürülür. `return_segmentation_scores=True` olduğunda, `segmentation` (sınıf kimlikleri, `(height, width)` biçimi) ve `segmentation_scores` (`(num_classes, height, width)` biçimi) alanlarına sahip `SemanticSegmentationPostProcessorOutput` nesnelerinden oluşan bir liste döndürülür. Her iki durumda da `(height, width)`, hedef boyuta (`target_sizes` belirtilmişse) karşılık gelir.
[BeitForSemanticSegmentation](/docs/transformers/main/tr/model_doc/beit#transformers.BeitForSemanticSegmentation) çıktısını anlamsal segmentasyon haritalarına dönüştürür.
## BeitModel[[transformers.BeitModel]]
#### transformers.BeitModel[[transformers.BeitModel]]
```python
transformers.BeitModel(config: BeitConfig, add_pooling_layer: bool = True)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L486)
**Parametreler:**
config ([BeitConfig](/docs/transformers/main/tr/model_doc/beit#transformers.BeitConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
add_pooling_layer (`bool`, *isteğe bağlı*, varsayılan `True`) : Bir havuzlama katmanı eklenip eklenmeyeceği
Üzerinde herhangi bir özel başlık olmadan ham gizli durumları (hidden-states) üreten çıplak Beit Modeli.
Bu model [PreTrainedModel](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.BeitModel.forward]]
```python
forward(pixel_values: Tensor, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, interpolate_pos_encoding: bool = False, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L512)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [BeitImageProcessor](/docs/transformers/main/tr/model_doc/beit#transformers.BeitImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [BeitImageProcessor.__call__()](/docs/transformers/main/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın (`processor_class`, görüntü işleme için [BeitImageProcessor](/docs/transformers/main/tr/model_doc/beit#transformers.BeitImageProcessor) kullanır).
bool_masked_pos (`torch.BoolTensor`, şekli `(batch_size, num_patches)`, *isteğe bağlı*) : Boole maskeli konumlar. Hangi yamaların maskelendiğini (1) ve hangilerinin maskelenmediğini (0) belirtir.
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
**Dönüş:** [BeitModelOutputWithPooling](/docs/transformers/main/tr/model_doc/beit#transformers.models.beit.modeling_beit.BeitModelOutputWithPooling) veya `tuple(torch.Tensor)`
[BeitModelOutputWithPooling](/docs/transformers/main/tr/model_doc/beit#transformers.models.beit.modeling_beit.BeitModelOutputWithPooling) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırma ([BeitConfig](/docs/transformers/main/tr/model_doc/beit#transformers.BeitConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[BeitModel](/docs/transformers/main/tr/model_doc/beit#transformers.BeitModel) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **last_hidden_state** (`torch.Tensor`, şekli `(batch_size, sequence_length, hidden_size)`) -- Modelin son katmanının çıktısındaki gizli durumlar dizisi.
- **pooler_output** (`torch.Tensor`, şekli `(batch_size, hidden_size)`) -- *config.use_mean_pooling* True olarak ayarlanmışsa, yama tokenlarının son katman gizli durumlarının ortalaması (*[CLS]* tokenı hariç). False olarak ayarlanmışsa, *[CLS]* tokenının son gizli durumu döndürülür.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnek:
```python
```
## BeitForMaskedImageModeling[[transformers.BeitForMaskedImageModeling]]
#### transformers.BeitForMaskedImageModeling[[transformers.BeitForMaskedImageModeling]]
```python
transformers.BeitForMaskedImageModeling(config: BeitConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L583)
**Parametreler:**
config ([BeitConfig](/docs/transformers/main/tr/model_doc/beit#transformers.BeitConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde bir 'language' modelleme başlığı bulunan Beit Model transformer'ı. BEiT, bir Vector-Quantize Variational Autoencoder (VQ-VAE)'nin görsel token'larını tahmin ederek maskeli görüntü modellemesi yapar; ViT ve DeiT gibi diğer görme modelleri ise RGB piksel değerlerini tahmin eder. Sonuç olarak, bu sınıf [AutoModelForMaskedImageModeling](/docs/transformers/main/tr/model_doc/auto#transformers.AutoModelForMaskedImageModeling) ile uyumsuzdur; BEiT ile maskeli görüntü modellemesi yapmak isterseniz [BeitForMaskedImageModeling](/docs/transformers/main/tr/model_doc/beit#transformers.BeitForMaskedImageModeling)'i doğrudan kullanmanız gerekir.
Bu model [PreTrainedModel](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.BeitForMaskedImageModeling.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, bool_masked_pos: typing.Optional[torch.BoolTensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, attention_mask: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L600)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [BeitImageProcessor](/docs/transformers/main/tr/model_doc/beit#transformers.BeitImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [BeitImageProcessor.__call__()](/docs/transformers/main/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın (`processor_class`, görüntüleri işlemek için [BeitImageProcessor](/docs/transformers/main/tr/model_doc/beit#transformers.BeitImageProcessor) kullanır).
bool_masked_pos (`torch.BoolTensor`, şekli `(batch_size, num_patches)`) : Boole maskeli konumlar. Hangi yamaların maskelendiğini (1) ve hangilerinin maskelenmediğini (0) belirtir.
labels (`torch.LongTensor`, şekli `(batch_size,)`, *isteğe bağlı*) : Görüntü sınıflandırma/geri dönüşüm kaybını hesaplamak için etiketler. Endeksler `[0, ..., config.num_labels - 1]` aralığında olmalıdır. `config.num_labels == 1` ise bir geri dönüşüm kaybı (Ortalama Kare kaybı) hesaplanır, `config.num_labels > 1` ise bir sınıflandırma kaybı (Çapraz Entropi) hesaplanır.
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
attention_mask (`torch.Tensor`, şekli `(batch_size, sequence_length)`, *isteğe bağlı*) : Dolgu (padding) token indekslerinde dikkat (attention) işleminin uygulanmamasını sağlayan maske. `[0, 1]` aralığında seçilen maske değerleri: - **maske uygulanmayan** tokenlar için 1, - **maske uygulanan** tokenlar için 0. [Dikkat maskeleri nelerdir?](../glossary#attention-mask)
**Dönüş:** [MaskedLMOutput](/docs/transformers/main/tr/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) veya `tuple(torch.Tensor)`
[MaskedLMOutput](/docs/transformers/main/tr/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([BeitConfig](/docs/transformers/main/tr/model_doc/beit#transformers.BeitConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[BeitForMaskedImageModeling](/docs/transformers/main/tr/model_doc/beit#transformers.BeitForMaskedImageModeling) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür) -- Maskeli dil modelleme (MLM) kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, sequence_length, config.vocab_size)`) -- Dil modelleme başlığının tahmin puanları (SoftMax öncesi her sözlük jetonu için puanlar).
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, sequence_length, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, sequence_length, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from transformers import AutoImageProcessor, BeitForMaskedImageModeling
>>> import torch
>>> from PIL import Image
>>> import requests
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForMaskedImageModeling.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> num_patches = (model.config.image_size // model.config.patch_size) ** 2
>>> pixel_values = image_processor(images=image, return_tensors="pt").pixel_values
>>> # create random boolean mask of shape (batch_size, num_patches)
>>> bool_masked_pos = torch.randint(low=0, high=2, size=(1, num_patches)).bool()
>>> outputs = model(pixel_values, bool_masked_pos=bool_masked_pos)
>>> loss, logits = outputs.loss, outputs.logits
>>> list(logits.shape)
[1, 196, 8192]
```
## BeitForImageClassification[[transformers.BeitForImageClassification]]
#### transformers.BeitForImageClassification[[transformers.BeitForImageClassification]]
```python
transformers.BeitForImageClassification(config: BeitConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L675)
**Parametreler:**
config ([BeitConfig](/docs/transformers/main/tr/model_doc/beit#transformers.BeitConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Beit Model, üstünde bir görüntü sınıflandırma başlığına sahip bir transformer (yama token'larının son gizli durumlarının ortalamasının üzerine yerleştirilen doğrusal bir katman) örneğin ImageNet için.
Bu model [PreTrainedModel](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.BeitForImageClassification.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L688)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [BeitImageProcessor](/docs/transformers/main/tr/model_doc/beit#transformers.BeitImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [BeitImageProcessor.__call__()](/docs/transformers/main/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın (`processor_class`, görüntüleri işlemek için [BeitImageProcessor](/docs/transformers/main/tr/model_doc/beit#transformers.BeitImageProcessor) kullanır).
labels (`torch.LongTensor`, şekli `(batch_size,)`, *isteğe bağlı*) : Görüntü sınıflandırma/geri dönüşüm kaybını hesaplamak için etiketler. Endeksler `[0, ..., config.num_labels - 1]` aralığında olmalıdır. `config.num_labels == 1` ise bir geri dönüşüm kaybı (Ortalama Kare kaybı) hesaplanır, `config.num_labels > 1` ise bir sınıflandırma kaybı (Çapraz Entropi) hesaplanır.
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
**Dönüş:** [ImageClassifierOutput](/docs/transformers/main/tr/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) veya `tuple(torch.Tensor)`
[ImageClassifierOutput](/docs/transformers/main/tr/main_classes/output#transformers.modeling_outputs.ImageClassifierOutput) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([BeitConfig](/docs/transformers/main/tr/model_doc/beit#transformers.BeitConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[BeitForImageClassification](/docs/transformers/main/tr/model_doc/beit#transformers.BeitForImageClassification) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür) -- Sınıflandırma (config.num_labels==1 ise regresyon) kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, config.num_labels)`) -- Sınıflandırma (veya config.num_labels==1 ise regresyon) puanları (SoftMax öncesi).
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (modelin bir gömme katmanı varsa gömme katmanının çıktısı için bir tane + her aşamanın çıktısı için bir tane) içeren bir tuple, şekli `(batch_size, sequence_length, hidden_size)`. Modelin her aşamanın çıktısındaki gizli durumları (aynı zamanda özellik haritaları olarak da adlandırılır).
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, patch_size, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnek:
```python
>>> from transformers import AutoImageProcessor, BeitForImageClassification
>>> import torch
>>> from datasets import load_dataset
>>> dataset = load_dataset("huggingface/cats-image")
>>> image = dataset["test"]["image"][0]
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> model = BeitForImageClassification.from_pretrained("microsoft/beit-base-patch16-224-pt22k")
>>> inputs = image_processor(image, return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # model predicts one of the 1000 ImageNet classes
>>> predicted_label = logits.argmax(-1).item()
>>> print(model.config.id2label[predicted_label])
...
```
## BeitForSemanticSegmentation[[transformers.BeitForSemanticSegmentation]]
#### transformers.BeitForSemanticSegmentation[[transformers.BeitForSemanticSegmentation]]
```python
transformers.BeitForSemanticSegmentation(config: BeitConfig)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L978)
**Parametreler:**
config ([BeitConfig](/docs/transformers/main/tr/model_doc/beit#transformers.BeitConfig)) : Modelin tüm parametrelerini içeren model yapılandırma sınıfı. Bir yapılandırma dosyasıyla başlatmak, modelle ilişkili ağırlıkları yüklemez, yalnızca yapılandırmayı yükler. Model ağırlıklarını yüklemek için [from_pretrained()](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel.from_pretrained) yöntemine göz atın.
Üzerinde örneğin ADE20K veya CityScapes için anlamsal segmentasyon başlığı bulunan Beit Modeli.
Bu model [PreTrainedModel](/docs/transformers/main/tr/main_classes/model#transformers.PreTrainedModel) sınıfından devralır. Kütüphanenin tüm modelleri için uyguladığı genel yöntemler (indirme veya kaydetme, giriş gömme boyutlarını yeniden ayarlama, başları budama vb.) için üst sınıf belgelendirmesine bakın.
Bu model aynı zamanda bir PyTorch [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) alt sınıfıdır. Bunu standart bir PyTorch Module olarak kullanın ve genel kullanım ve davranışla ilgili tüm konular için PyTorch dokümantasyonuna başvurun.
#### forward[[transformers.BeitForSemanticSegmentation.forward]]
```python
forward(pixel_values: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, interpolate_pos_encoding: bool = False, **kwargs: *)
```
[Kaynak](https://github.com/huggingface/transformers/blob/main/src/transformers/models/beit/modeling_beit.py#L1000)
**Parametreler:**
pixel_values (`torch.Tensor`, şekli `(batch_size, num_channels, image_size, image_size)`, *isteğe bağlı*) : Girdi görüntülerine karşılık gelen tensörler. Piksel değerleri [BeitImageProcessor](/docs/transformers/main/tr/model_doc/beit#transformers.BeitImageProcessor) kullanılarak elde edilebilir. Ayrıntılar için [BeitImageProcessor.__call__()](/docs/transformers/main/tr/model_doc/molmo2#transformers.Molmo2ImageProcessor.__call__) bölümüne bakın (`processor_class`, görüntüleri işlemek için [BeitImageProcessor](/docs/transformers/main/tr/model_doc/beit#transformers.BeitImageProcessor) kullanır).
labels (`torch.LongTensor`, şekli `(batch_size, height, width)`, *isteğe bağlı*) : Kayıp hesabı için kullanılan gerçeklik semantik segmentasyon haritaları. İndisler `[0, ..., config.num_labels - 1]` aralığında olmalıdır. `config.num_labels > 1` ise bir sınıflandırma kaybı hesaplanır (Cross-Entropy).
interpolate_pos_encoding (`bool`, *isteğe bağlı*, varsayılan `False`) : Ön eğitilmiş konum kodlamalarının interpolasyonunun yapılıp yapılmayacağını belirtir.
**Dönüş:** [SemanticSegmenterOutput](/docs/transformers/main/tr/main_classes/output#transformers.modeling_outputs.SemanticSegmenterOutput) veya `tuple(torch.Tensor)`
[SemanticSegmenterOutput](/docs/transformers/main/tr/main_classes/output#transformers.modeling_outputs.SemanticSegmenterOutput) veya bir `torch.Tensor` demeti (eğer `return_dict=False` geçirildiyse veya `config.return_dict=False` ise), yapılandırmaya ([BeitConfig](/docs/transformers/main/tr/model_doc/beit#transformers.BeitConfig)) ve girdilere bağlı olarak çeşitli öğelerden oluşur.
[BeitForSemanticSegmentation](/docs/transformers/main/tr/model_doc/beit#transformers.BeitForSemanticSegmentation) forward metodu, `__call__` özel metodunu geçersiz kılar.
İleri geçiş tarifi bu fonksiyon içinde tanımlanmalı olsa da, sonrasında bunun yerine `Module` örneğini çağırmak gerekir; çünkü ilki ön ve son işleme adımlarını çalıştırmaktan sorumluyken ikincisi bunları sessizce yok sayar.
- **loss** (`torch.Tensor`, şekli `(1,)`, *isteğe bağlı*, `labels` sağlandığında döndürülür) -- Sınıflandırma (config.num_labels==1 ise regresyon) kaybı.
- **logits** (`torch.Tensor`, şekli `(batch_size, config.num_labels, logits_height, logits_width)`) -- Her piksel için sınıflandırma puanları.
Döndürülen logits değerlerinin boyutu, girdi olarak geçirilen `pixel_values` ile aynı olmak zorunda değildir. Bu, bir kullanıcının logits değerlerini son işlem olarak orijinal görüntü boyutuna yeniden boyutlandırdığında iki kez interpolasyon yapılarak bazı kalite kayıpları yaşanmasını önlemek içindir. Logits şeklinizi her zaman kontrol etmeli ve gerektiğinde yeniden boyutlandırmalısınız.
- **hidden_states** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_hidden_states=True` geçirildiğinde veya `config.output_hidden_states=True` olduğunda döndürülür) -- `torch.Tensor` (gömme katmanı varsa gömme katmanının çıktısı için bir tane + her katmanın çıktısı için bir tane) içeren, `(batch_size, patch_size, hidden_size)` biçiminde bir demet.
Her katmanın çıktısında modelin gizli durumları ve isteğe bağlı başlangıç gömme çıktıları.
- **attentions** (`tuple(torch.Tensor)`, *isteğe bağlı*, `output_attentions=True` geçirildiğinde veya `config.output_attentions=True` olduğunda döndürülür) -- `torch.Tensor` (her katman için bir tane) içeren bir tuple, şekli `(batch_size, num_heads, patch_size, sequence_length)`.
Dikkat softmax'ı sonrası dikkat ağırlıkları, öz-dikkat kafalarında ağırlıklı ortalamanın hesaplanmasında kullanılır.
Örnekler:
```python
>>> from transformers import AutoImageProcessor, BeitForSemanticSegmentation
>>> from PIL import Image
>>> import requests
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> image = Image.open(requests.get(url, stream=True).raw)
>>> image_processor = AutoImageProcessor.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")
>>> model = BeitForSemanticSegmentation.from_pretrained("microsoft/beit-base-finetuned-ade-640-640")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # logits are of shape (batch_size, num_labels, height, width)
>>> logits = outputs.logits
```