# Deformable DETR
[Deformable DETR](https://huggingface.co/papers/2010.04159) mejora al [DETR](./detr) original mediante el uso de un módulo de atención deformable. Este mecanismo atiende selectivamente a un pequeño conjunto de puntos de muestreo clave alrededor de una referencia. Mejora la velocidad de entrenamiento y la precisión.
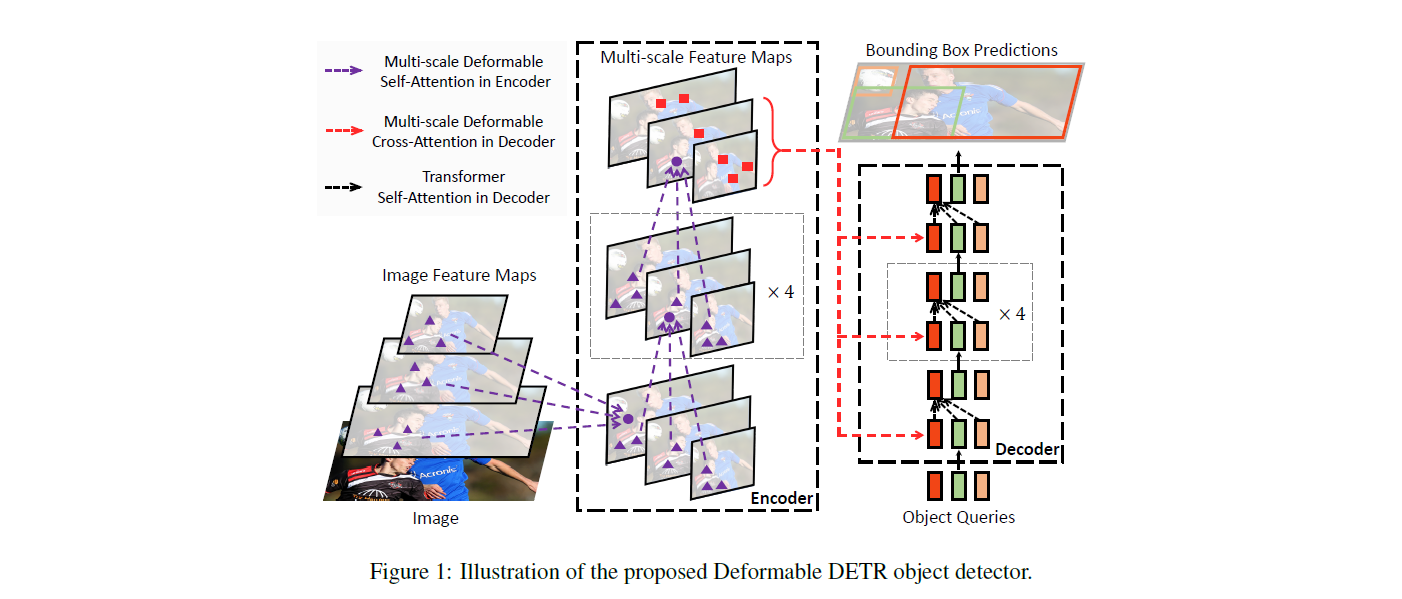 Arquitectura de Deformable DETR. Tomada del artículo original.
Puedes encontrar todos los puntos de control disponibles de Deformable DETR bajo la organización [SenseTime](https://huggingface.co/SenseTime).
> [!TIP]
> Este modelo fue aportado por [nielsr](https://huggingface.co/nielsr).
>
> Haz clic en los modelos Deformable DETR en la barra lateral derecha para ver más ejemplos de cómo aplicar Deformable DETR a diferentes tareas de detección de objetos y segmentación.
El siguiente ejemplo demuestra cómo realizar la detección de objetos con la clase [Pipeline](/docs/transformers/v5.23.0/es/main_classes/pipelines#transformers.Pipeline) y la clase [AutoModel](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoModel).
```python
from transformers import pipeline
pipeline = pipeline(
"object-detection",
model="SenseTime/deformable-detr",
device_map=0
)
pipeline("http://images.cocodataset.org/val2017/000000039769.jpg")
```
```python
import requests
import torch
from PIL import Image
from transformers import AutoImageProcessor, AutoModelForObjectDetection
url = "http://images.cocodataset.org/val2017/000000039769.jpg"
image = Image.open(requests.get(url, stream=True).raw)
image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
model = AutoModelForObjectDetection.from_pretrained("SenseTime/deformable-detr", device_map="auto")
# prepare image for the model
inputs = image_processor(images=image, return_tensors="pt").to(model.device)
with torch.no_grad():
outputs = model(**inputs)
results = image_processor.post_process_object_detection(outputs, target_sizes=torch.tensor([image.size[::-1]]), threshold=0.3)
for result in results:
for score, label_id, box in zip(result["scores"], result["labels"], result["boxes"]):
score, label = score.item(), label_id.item()
box = [round(i, 2) for i in box.tolist()]
print(f"{model.config.id2label[label]}: {score:.2f} {box}")
```
## Recursos
- Consulte este conjunto de [notebooks](https://github.com/NielsRogge/Transformers-Tutorials/tree/master/Deformable-DETR) para la inferencia y el ajuste fino de [DeformableDetrForObjectDetection](/docs/transformers/v5.23.0/es/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) en un conjunto de datos personalizado.
## DeformableDetrImageProcessor[[transformers.DeformableDetrImageProcessor]]
#### transformers.DeformableDetrImageProcessor[[transformers.DeformableDetrImageProcessor]]
```python
transformers.DeformableDetrImageProcessor(**kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L271)
**Parámetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'shortest_edge' : 800, 'longest_edge': 1333}`): Describe las dimensiones máximas de entrada para el modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `False`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando size es un int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, por defecto `2`) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.485, 0.456, 0.406]`) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.229, 0.224, 0.225]`) : Desviación estándar de la imagen que se utilizará para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el mayor tamaño del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
format (`str`, *kwargs*, *opcional*, por defecto `AnnotationFormat.COCO_DETECTION`) : Formato de datos de las anotaciones. Uno de "coco_detection" o "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Controla si se deben convertir las anotaciones al formato esperado por el modelo DEFORMABLE_DETR. Convierte las cajas delimitadoras al formato `(center_x, center_y, width, height)` y en el rango `[0, 1]`. Se puede anular mediante el parámetro `do_convert_annotations` en el método `preprocess`.
Construye un procesador de imágenes DeformableDetrImageProcessor.
#### preprocess[[transformers.DeformableDetrImageProcessor.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L526)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
annotations (`AnnotationType` o `list[AnnotationType]`, *opcional*) : Anotaciones que se transformarán según el relleno aplicado a las imágenes.
return_segmentation_masks (`bool`, *opcional*, valor predeterminado `self.return_segmentation_masks`) : Si se deben devolver las máscaras de segmentación.
masks_path (`str` o `pathlib.Path`, *opcional*) : Ruta al directorio que contiene las máscaras de segmentación.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
format (`str`, *kwargs*, *opcional*, por defecto `AnnotationFormat.COCO_DETECTION`) : Formato de datos de las anotaciones. Uno de "coco_detection" o "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Controla si se deben convertir las anotaciones al formato esperado por el modelo DEFORMABLE_DETR. Convierte las cajas delimitadoras al formato `(center_x, center_y, width, height)` y en el rango `[0, 1]`. Se puede anular mediante el parámetro `do_convert_annotations` en el método `preprocess`.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
#### post_process_object_detection[[transformers.DeformableDetrImageProcessor.post_process_object_detection]]
```python
post_process_object_detection(outputs, threshold: float = 0.5, target_sizes: transformers.utils.generic.TensorType | list[tuple] = None, top_k: int = 100)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/deformable_detr/image_processing_deformable_detr.py#L667)
**Parámetros:**
outputs (`DetrObjectDetectionOutput`) : Salidas crudas del modelo.
threshold (`float`, *opcional*) : Umbral de puntuación para conservar las predicciones de detección de objetos.
target_sizes (`torch.Tensor` o `list[tuple[int, int]]`, *opcional*) : Tensor de forma `(batch_size, 2)` o lista de tuplas (`tuple[int, int]`) que contiene el tamaño objetivo (altura, ancho) de cada imagen del lote. Si se deja en None, las predicciones no se redimensionarán.
top_k (`int`, *opcional*, valor predeterminado 100) : Conserva solo los k recuadros delimitadores principales antes de filtrar mediante umbral.
**Devuelve:** `list[Dict]`
Una lista de diccionarios, donde cada diccionario contiene las puntuaciones, las etiquetas y las cajas de una imagen del lote, tal como las predice el modelo.
Convierte la salida cruda de [DeformableDetrForObjectDetection](/docs/transformers/v5.23.0/es/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) en cajas delimitadoras finales en el formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y). Solo admite PyTorch.
## DeformableDetrImageProcessorPil[[transformers.DeformableDetrImageProcessorPil]]
#### transformers.DeformableDetrImageProcessorPil[[transformers.DeformableDetrImageProcessorPil]]
```python
transformers.DeformableDetrImageProcessorPil(**kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L263)
**Parámetros:**
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*, por defecto `{'shortest_edge' : 800, 'longest_edge': 1333}`): Describe las dimensiones máximas de entrada para el modelo.
default_to_square (`bool`, *kwargs*, *opcional*, valor predeterminado `False`) : Si se debe usar una imagen cuadrada por defecto al redimensionar, cuando size es un int.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*, por defecto `2`) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*, valor predeterminado `0.00392156862745098`) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.485, 0.456, 0.406]`) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*, valor predeterminado `[0.229, 0.224, 0.225]`) : Desviación estándar de la imagen que se utilizará para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el mayor tamaño del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
format (`str`, *kwargs*, *opcional*, por defecto `AnnotationFormat.COCO_DETECTION`) : Formato de datos de las anotaciones. Uno de "coco_detection" o "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Controla si se deben convertir las anotaciones al formato esperado por el modelo DEFORMABLE_DETR. Convierte las cajas delimitadoras al formato `(center_x, center_y, width, height)` y en el rango `[0, 1]`. Se puede anular mediante el parámetro `do_convert_annotations` en el método `preprocess`.
Construye un procesador de imágenes DeformableDetrImageProcessor.
#### preprocess[[transformers.DeformableDetrImageProcessorPil.preprocess]]
```python
preprocess(images: typing.Union[ForwardRef('PIL.Image.Image'), numpy.ndarray, ForwardRef('torch.Tensor'), list['PIL.Image.Image'], list[numpy.ndarray], list['torch.Tensor']], annotations: dict[str, int | str | list[dict]] | list[dict[str, int | str | list[dict]]] | None = None, return_segmentation_masks: bool | None = None, masks_path: str | pathlib.Path | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L531)
**Parámetros:**
images (`Union[PIL.Image.Image, numpy.ndarray, torch.Tensor, list[PIL.Image.Image], list[numpy.ndarray], list[torch.Tensor]]`) : Imagen a preprocesar. Espera una imagen única o un lote de imágenes con valores de píxeles que van de 0 a 255. Si se pasan imágenes con valores de píxeles entre 0 y 1, establezca `do_rescale=False`.
annotations (`AnnotationType` o `list[AnnotationType]`, *opcional*) : Anotaciones que se transformarán según el relleno aplicado a las imágenes.
return_segmentation_masks (`bool`, *opcional*, valor predeterminado `self.return_segmentation_masks`) : Si se deben devolver las máscaras de segmentación.
masks_path (`str` o `pathlib.Path`, *opcional*) : Ruta al directorio que contiene las máscaras de segmentación.
do_convert_rgb (`bool`, *kwargs*, *opcional*) : Si se debe convertir la imagen a RGB.
do_resize (`bool`, *kwargs*, *opcional*) : Si se debe redimensionar la imagen.
size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Describe las dimensiones máximas de entrada del modelo.
default_to_square (`bool`, *kwargs*, *opcional*) : Si el tamaño es un entero, si se debe usar una imagen cuadrada por defecto al redimensionar.
crop_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : Tamaño de la imagen de salida tras aplicar `center_crop`.
resample (`Annotated[Union[int, PILImageResampling, NoneType], None]`, *kwargs*) : Filtro de remuestreo que se utilizará si se redimensiona la imagen. Puede ser uno de los valores de la enumeración `PILImageResampling`. Solo tiene efecto si `do_resize` está establecido en `True`.
do_rescale (`bool`, *kwargs*, *opcional*) : Si se debe reescalar la imagen.
rescale_factor (`float`, *kwargs*, *opcional*) : Factor de reescalado para reescalar la imagen si `do_rescale` está establecido en `True`.
do_normalize (`bool`, *kwargs*, *opcional*) : Si se debe normalizar la imagen.
image_mean (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Media de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
image_std (`Union[float, list[float], tuple[float, ...]]`, *kwargs*, *opcional*) : Desviación estándar de la imagen a utilizar para la normalización. Solo tiene efecto si `do_normalize` está establecido en `True`.
do_pad (`bool`, *kwargs*, *opcional*) : Indica si se debe aplicar relleno a la imagen. El relleno se realiza hasta el tamaño más grande del lote o hasta un tamaño cuadrado fijo por imagen. La estrategia exacta de relleno depende del modelo.
pad_size (`Annotated[int | list[int] | tuple[int, ...] | dict[str, int] | None, None]`, *kwargs*) : El tamaño en `{"height": int, "width" int}` al que se rellenan las imágenes. Debe ser mayor que el tamaño de cualquier imagen proporcionada para el preprocesamiento. Si no se proporciona `pad_size`, las imágenes se rellenarán hasta la mayor altura y anchura del lote. Se aplica solo cuando `do_pad=True.`
do_center_crop (`bool`, *kwargs*, *opcional*) : Si se debe recortar la imagen centrada.
data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : Solo se admite `ChannelDimension.FIRST`. Se añadió para garantizar la compatibilidad con los procesadores lentos.
input_data_format (`Union[str, ~image_utils.ChannelDimension]`, *kwargs*, *opcional*) : El formato de la dimensión de canal para la imagen de entrada. Si no se establece, el formato de la dimensión de canal se infiere a partir de la imagen de entrada. Puede ser uno de: - `"channels_first"` o `ChannelDimension.FIRST`: imagen en formato (num_channels, height, width). - `"channels_last"` o `ChannelDimension.LAST`: imagen en formato (height, width, num_channels). - `"none"` o `ChannelDimension.NONE`: imagen en formato (height, width).
device (`Annotated[Union[str, torch.device, NoneType], None]`, *kwargs*) : El dispositivo en el que se procesarán los vídeos. Si no se establece, el dispositivo se infiere a partir de los vídeos de entrada.
return_tensors (`Annotated[str | ~utils.generic.TensorType | None, None]`, *kwargs*) : Devuelve tensores apilados si se establece en `'pt'`; en caso contrario, devuelve una lista de tensores.
disable_grouping (`bool`, *kwargs*, *opcional*) : Si se debe deshabilitar el agrupamiento de imágenes por tamaño para procesarlas de forma individual y no en lotes. Si es None, se establecerá en True si las imágenes están en CPU, y en False en caso contrario. Esta elección se basa en observaciones empíricas, como se detalla aquí: https://github.com/huggingface/transformers/pull/38157
image_seq_length (`int`, *kwargs*, *opcional*) : El número de tokens de imagen que se utilizarán para cada imagen en la entrada. Se añadió por compatibilidad con versiones anteriores, pero en los modelos futuros esto debería configurarse como un atributo del procesador.
format (`str`, *kwargs*, *opcional*, por defecto `AnnotationFormat.COCO_DETECTION`) : Formato de datos de las anotaciones. Uno de "coco_detection" o "coco_panoptic".
do_convert_annotations (`bool`, *kwargs*, *opcional*, valor predeterminado `True`) : Controla si se deben convertir las anotaciones al formato esperado por el modelo DEFORMABLE_DETR. Convierte las cajas delimitadoras al formato `(center_x, center_y, width, height)` y en el rango `[0, 1]`. Se puede anular mediante el parámetro `do_convert_annotations` en el método `preprocess`.
**Devuelve:** `~image_processing_base.BatchFeature`
- **data** (`dict`) -- Diccionario de listas/arrays/tensores devueltos por el método __call__ ('pixel_values', etc.).
- **tensor_type** (`Union[None, str, TensorType]`, *opcional*) -- Puede especificar un tensor_type aquí para convertir las listas de enteros en Tensors de PyTorch/Numpy durante la inicialización.
#### post_process_object_detection[[transformers.DeformableDetrImageProcessorPil.post_process_object_detection]]
```python
post_process_object_detection(outputs, threshold: float = 0.5, target_sizes: transformers.utils.generic.TensorType | list[tuple] = None, top_k: int = 100)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/deformable_detr/image_processing_pil_deformable_detr.py#L676)
**Parámetros:**
outputs (`DetrObjectDetectionOutput`) : Salidas crudas del modelo.
threshold (`float`, *opcional*) : Umbral de puntuación para conservar las predicciones de detección de objetos.
target_sizes (`torch.Tensor` o `list[tuple[int, int]]`, *opcional*) : Tensor de forma `(batch_size, 2)` o lista de tuplas (`tuple[int, int]`) que contiene el tamaño objetivo (altura, ancho) de cada imagen del lote. Si se deja en None, las predicciones no se redimensionarán.
top_k (`int`, *opcional*, valor predeterminado 100) : Conserva solo los k recuadros delimitadores principales antes de filtrar mediante umbral.
**Devuelve:** `list[Dict]`
Una lista de diccionarios, donde cada diccionario contiene las puntuaciones, las etiquetas y las cajas de una imagen del lote, tal como las predice el modelo.
Convierte la salida cruda de [DeformableDetrForObjectDetection](/docs/transformers/v5.23.0/es/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) en cajas delimitadoras finales en el formato (top_left_x, top_left_y, bottom_right_x, bottom_right_y). Solo admite PyTorch.
## DeformableDetrConfig[[transformers.DeformableDetrConfig]]
#### transformers.DeformableDetrConfig[[transformers.DeformableDetrConfig]]
```python
transformers.DeformableDetrConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, is_encoder_decoder: bool = True, backbone_config: dict | transformers.configuration_utils.PreTrainedConfig | None = None, num_channels: int = 3, num_queries: int = 300, max_position_embeddings: int = 1024, encoder_layers: int = 6, encoder_ffn_dim: int = 1024, encoder_attention_heads: int = 8, decoder_layers: int = 6, decoder_ffn_dim: int = 1024, decoder_attention_heads: int = 8, encoder_layerdrop: float | int = 0.0, activation_function: str = 'relu', d_model: int = 256, dropout: float | int = 0.1, attention_dropout: float | int = 0.0, activation_dropout: float | int = 0.0, init_std: float = 0.02, init_xavier_std: float = 1.0, return_intermediate: bool = True, auxiliary_loss: bool = False, position_embedding_type: str = 'sine', dilation: bool = False, num_feature_levels: int = 4, encoder_n_points: int = 4, decoder_n_points: int = 4, two_stage: bool = False, two_stage_num_proposals: int = 300, with_box_refine: bool = False, class_cost: int = 1, bbox_cost: int = 5, giou_cost: int = 2, mask_loss_coefficient: int = 1, dice_loss_coefficient: int = 1, bbox_loss_coefficient: int = 5, giou_loss_coefficient: int = 2, eos_coefficient: float = 0.1, focal_alpha: float = 0.25, disable_custom_kernels: bool = False, tie_word_embeddings: bool = True)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/deformable_detr/configuration_deformable_detr.py#L25)
**Parámetros:**
is_encoder_decoder (`bool`, *opcional*, valor predeterminado `True`) : Indica si el modelo se utiliza como codificador/decodificador o no.
backbone_config (`Union[dict, ~configuration_utils.PreTrainedConfig]`, *opcional*) : La configuración del modelo de base.
num_channels (`int`, *opcional*, valor predeterminado `3`) : El número de canales de entrada.
num_queries (`int`, *opcional*, valor predeterminado 300) : Número de consultas de objetos, es decir, ranuras de detección. Este es el número máximo de objetos que [DeformableDetrModel](/docs/transformers/v5.23.0/es/model_doc/deformable_detr#transformers.DeformableDetrModel) puede detectar en una sola imagen. En caso de que `two_stage` se establezca en `True`, se utiliza `two_stage_num_proposals` en su lugar.
max_position_embeddings (`int`, *opcional*, valor predeterminado `1024`) : La longitud máxima de secuencia con la que se podría utilizar este modelo.
encoder_layers (`int`, *opcional*, valor predeterminado `6`) : Número de capas ocultas en el codificador Transformer. Usará el mismo valor que `num_layers` si no se establece.
encoder_ffn_dim (`int`, *opcional*, valor predeterminado `1024`) : Dimensionalidad de la capa "intermedia" (a menudo denominada feed-forward) en el codificador.
encoder_attention_heads (`int`, *opcional*, valor predeterminado `8`) : Número de cabezas de atención para cada capa de atención en el codificador Transformer.
decoder_layers (`int`, *opcional*, valor predeterminado `6`) : Número de capas ocultas en el decodificador Transformer. Usará el mismo valor que `num_layers` si no se establece.
decoder_ffn_dim (`int`, *opcional*, valor predeterminado `1024`) : Dimensionalidad de la capa "intermedia" (a menudo denominada feed-forward) en el decodificador.
decoder_attention_heads (`int`, *opcional*, valor predeterminado `8`) : Número de cabezas de atención para cada capa de atención en el decodificador del Transformer.
encoder_layerdrop (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : La probabilidad de LayerDrop para el codificador. Consulte el [artículo de LayerDrop](see https://huggingface.co/papers/1909.11556) para obtener más detalles.
activation_function (`str`, *opcional*, valor predeterminado `relu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
d_model (`int`, *opcional*, valor predeterminado `256`) : Tamaño de las capas del codificador y de la capa pooler.
dropout (`Union[float, int]`, *opcional*, valor predeterminado `0.1`) : La proporción para todas las capas de dropout.
attention_dropout (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : La proporción de dropout para las probabilidades de atención.
activation_dropout (`Union[float, int]`, *opcional*, valor predeterminado `0.0`) : La proporción de dropout para las activaciones dentro de la capa totalmente conectada.
init_std (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
init_xavier_std (`float`, *opcional*, valor predeterminado `1.0`) : El factor de escala utilizado para la inicialización de Xavier de los pesos de la atención cruzada.
return_intermediate (`bool`, *opcional*, predeterminado a True) : Si se devuelve o no el estado intermedio
auxiliary_loss (`bool`, *opcional*, valor predeterminado `False`) : Si se deben utilizar las pérdidas de decodificación auxiliares (pérdidas en cada capa del decodificador).
position_embedding_type (`str`, *opcional*, valor predeterminado `"sine"`) : Tipo de incrustaciones de posición que se utilizará sobre las características de la imagen. Uno de `"sine"` o `"learned"`.
dilation (`bool`, *opcional*, valor predeterminado `False`) : Si se debe reemplazar el stride con la dilatación en el último bloque convolucional (DC5). Solo se admite cuando `use_timm_backbone` = `True`.
num_feature_levels (`int`, *opcional*, valor predeterminado 4) : El número de niveles de características de entrada.
encoder_n_points (`int`, *opcional*, valor predeterminado: 4) : El número de claves muestreadas en cada nivel de características para cada cabeza de atención en el codificador.
decoder_n_points (`int`, *opcional*, valor predeterminado: 4) : El número de claves muestreadas en cada nivel de características para cada cabeza de atención en el decodificador.
two_stage (`bool`, *opcional*, valor predeterminado `False`) : Indica si se debe aplicar un DETR deformable de dos etapas, en el que las propuestas de región también se generan mediante una variante de Deformable DETR, que luego se introducen en el decodificador para un refinamiento iterativo de las cajas delimitadoras.
two_stage_num_proposals (`int`, *opcional*, valor predeterminado 300) : El número de propuestas de región que se generarán, en caso de que `two_stage` esté establecido en `True`.
with_box_refine (`bool`, *opcional*, valor predeterminado `False`) : Indica si se debe aplicar un refinamiento iterativo de las cajas delimitadoras, donde cada capa del decodificador refina las cajas delimitadoras en función de las predicciones de la capa anterior.
class_cost (`int`, *opcional*, valor predeterminado `1`) : Peso relativo del error de clasificación en el coste de correspondencia húngara.
bbox_cost (`int`, *opcional*, valor predeterminado `5`) : Peso relativo del error de la caja delimitadora L1 en el costo de correspondencia húngara.
giou_cost (`int`, *opcional*, valor predeterminado `2`) : Peso relativo de la pérdida de IoU generalizada en el costo de correspondencia húngara.
mask_loss_coefficient (`int`, *opcional*, valor predeterminado `1`) : Peso relativo de la pérdida focal en la pérdida de segmentación panóptica.
dice_loss_coefficient (`int`, *opcional*, valor predeterminado `1`) : Peso relativo de la pérdida dice en la pérdida de segmentación panóptica.
bbox_loss_coefficient (`int`, *opcional*, valor predeterminado `5`) : Peso relativo de la pérdida de caja delimitadora L1 en la pérdida de segmentación panóptica.
giou_loss_coefficient (`int`, *opcional*, valor predeterminado `2`) : Peso relativo de la pérdida de IoU generalizada en la pérdida de segmentación panóptica.
eos_coefficient (`float`, *opcional*, valor predeterminado `0.1`) : Peso de clasificación relativo de la clase 'no-object' en la función de pérdida de detección de objetos.
focal_alpha (`float`, *opcional*, valor predeterminado `0.25`) : Parámetro alfa en la pérdida focal.
disable_custom_kernels (`bool`, *opcional*, valor predeterminado `False`) : Desactiva el uso de kernels personalizados de CUDA y CPU. Esta opción es necesaria para la exportación a ONNX, ya que los kernels personalizados no son compatibles con la exportación ONNX de PyTorch.
tie_word_embeddings (`bool`, *opcional*, valor predeterminado `True`) : Indica si se deben vincular las incrustaciones de pesos según el mapeo `tied_weights_keys` del modelo.
Esta es la clase de configuración para almacenar la configuración de un DeformableDetrModel. Se utiliza para instanciar un modelo Deformable Detr según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [SenseTime/deformable-detr](https://huggingface.co/SenseTime/deformable-detr)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplos:
```python
>>> from transformers import DeformableDetrConfig, DeformableDetrModel
>>> # Initializing a Deformable DETR SenseTime/deformable-detr style configuration
>>> configuration = DeformableDetrConfig()
>>> # Initializing a model (with random weights) from the SenseTime/deformable-detr style configuration
>>> model = DeformableDetrModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## DeformableDetrModel[[transformers.DeformableDetrModel]]
#### transformers.DeformableDetrModel[[transformers.DeformableDetrModel]]
```python
transformers.DeformableDetrModel(config: DeformableDetrConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1145)
**Parámetros:**
config ([DeformableDetrConfig](/docs/transformers/v5.23.0/es/model_doc/deformable_detr#transformers.DeformableDetrConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo Deformable DETR básico (constituido por un backbone y un Transformer encoder-decoder) que genera hidden-states sin procesar, sin ninguna cabeza específica en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.DeformableDetrModel.forward]]
```python
forward(pixel_values: Tensor, pixel_mask: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1319)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener mediante `image_processor_class`. Consulte `image_processor_class.__call__` para más detalles (`processor_class` utiliza `image_processor_class` para procesar las imágenes).
pixel_mask (`torch.LongTensor` de forma `(batch_size, height, width)`, *opcional*) : Máscara para evitar realizar atención sobre los valores de píxeles de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para píxeles reales (es decir, **no enmascarados**), - 0 para píxeles de relleno (es decir, **enmascarados**). [¿Qué son las máscaras de atención?](../glossary#attention-mask)
decoder_attention_mask (`torch.Tensor` de forma `(batch_size, num_queries)`, *opcional*) : No se utiliza de forma predeterminada. Puede usarse para enmascarar consultas de objetos.
encoder_outputs (`torch.Tensor`, *opcional*) : Tupla compuesta por (`last_hidden_state`, *opcional*: `hidden_states`, *opcional*: `attentions`) `last_hidden_state` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) es una secuencia de estados ocultos en la salida de la última capa del codificador. Se utiliza en la atención cruzada del decodificador.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar el mapa de características aplanado (salida del backbone + capa de proyección), puede elegir pasar directamente una representación aplanada de una imagen.
decoder_inputs_embeds (`torch.Tensor` de forma `(batch_size, num_queries, hidden_size)`, *opcional*) : Opcionalmente, en lugar de inicializar las consultas con un tensor de ceros, puede elegir pasar directamente una representación incrustada.
**Devuelve:** `DeformableDetrModelOutput` o `tuple(torch.Tensor)`
Un `DeformableDetrModelOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración (`None`) y las entradas.
El método forward de [DeformableDetrModel](/docs/transformers/v5.23.0/es/model_doc/deformable_detr#transformers.DeformableDetrModel) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **init_reference_points** (`torch.Tensor` de forma `(batch_size, num_queries, 4)`) -- Puntos de referencia iniciales enviados a través del decodificador Transformer.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, num_queries, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del decodificador del modelo.
- **intermediate_hidden_states** (`torch.Tensor` de forma `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- Estados ocultos intermedios apilados (salida de cada capa del decodificador).
- **intermediate_reference_points** (`torch.Tensor` de forma `(batch_size, config.decoder_layers, num_queries, 4)`) -- Puntos de referencia intermedios apilados (puntos de referencia de cada capa del decodificador).
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del decodificador en la salida de cada capa más las salidas de la incrustación inicial.
- **decoder_attentions** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención del decodificador, después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
- **cross_attentions** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención de la capa de atención cruzada del decodificador, después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de atención cruzada.
- **encoder_last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Secuencia de estados ocultos en la salida de la última capa del codificador del modelo.
- **encoder_hidden_states** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del codificador en la salida de cada capa más las salidas de la incrustación inicial.
- **encoder_attentions** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención del codificador, después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
- **enc_outputs_class** (`torch.Tensor` de forma `(batch_size, sequence_length, config.num_labels)`, *opcional*, devuelto cuando `config.with_box_refine=True` y `config.two_stage=True`) -- Puntuaciones de las cajas delimitadoras predichas, donde las `config.two_stage_num_proposals` cajas delimitadoras con mayor puntuación se seleccionan como propuestas de región en la primera etapa. Salida de la clasificación binaria de cajas delimitadoras (es decir, primer plano y fondo).
- **enc_outputs_coord_logits** (`torch.Tensor` de forma `(batch_size, sequence_length, 4)`, *opcional*, se devuelve cuando `config.with_box_refine=True` y `config.two_stage=True`) -- Logits de las coordenadas de las cajas delimitadoras predichas en la primera etapa.
Ejemplos:
```python
>>> from transformers import AutoImageProcessor, DeformableDetrModel
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
>>> model = DeformableDetrModel.from_pretrained("SenseTime/deformable-detr")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> last_hidden_states = outputs.last_hidden_state
>>> list(last_hidden_states.shape)
[1, 300, 256]
```
## DeformableDetrForObjectDetection[[transformers.DeformableDetrForObjectDetection]]
#### transformers.DeformableDetrForObjectDetection[[transformers.DeformableDetrForObjectDetection]]
```python
transformers.DeformableDetrForObjectDetection(config: DeformableDetrConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1542)
**Parámetros:**
config ([DeformableDetrConfig](/docs/transformers/v5.23.0/es/model_doc/deformable_detr#transformers.DeformableDetrConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Modelo Deformable DETR (constituido por un backbone y un Transformer encoder-decoder) con cabezas de detección de objetos en la parte superior, para tareas como la detección COCO.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.DeformableDetrForObjectDetection.forward]]
```python
forward(pixel_values: Tensor, pixel_mask: typing.Optional[torch.LongTensor] = None, decoder_attention_mask: typing.Optional[torch.Tensor] = None, encoder_outputs: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, decoder_inputs_embeds: typing.Optional[torch.Tensor] = None, labels: list[dict] | None = None, **kwargs: *)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/deformable_detr/modeling_deformable_detr.py#L1580)
**Parámetros:**
pixel_values (`torch.Tensor` de forma `(batch_size, num_channels, image_size, image_size)`) : Los tensores correspondientes a las imágenes de entrada. Los valores de píxeles se pueden obtener mediante `image_processor_class`. Consulte `image_processor_class.__call__` para más detalles (`processor_class` utiliza `image_processor_class` para procesar las imágenes).
pixel_mask (`torch.LongTensor` de forma `(batch_size, height, width)`, *opcional*) : Máscara para evitar realizar atención sobre los valores de píxeles de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para píxeles reales (es decir, **no enmascarados**), - 0 para píxeles de relleno (es decir, **enmascarados**). [¿Qué son las máscaras de atención?](../glossary#attention-mask)
decoder_attention_mask (`torch.Tensor` de forma `(batch_size, num_queries)`, *opcional*) : No se utiliza de forma predeterminada. Puede usarse para enmascarar consultas de objetos.
encoder_outputs (`torch.Tensor`, *opcional*) : Tupla compuesta por (`last_hidden_state`, *opcional*: `hidden_states`, *opcional*: `attentions`) `last_hidden_state` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) es una secuencia de estados ocultos en la salida de la última capa del codificador. Se utiliza en la atención cruzada del decodificador.
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar el mapa de características aplanado (salida del backbone + capa de proyección), puede elegir pasar directamente una representación aplanada de una imagen.
decoder_inputs_embeds (`torch.Tensor` de forma `(batch_size, num_queries, hidden_size)`, *opcional*) : Opcionalmente, en lugar de inicializar las consultas con un tensor de ceros, puede elegir pasar directamente una representación incrustada.
labels (`list[Dict]` de longitud `(batch_size,)`, *opcional*) : Etiquetas para calcular la pérdida de bipartite matching. Lista de diccionarios, donde cada diccionario contiene al menos las siguientes 2 claves: 'class_labels' y 'boxes' (las etiquetas de clase y las cajas delimitadoras de una imagen en el lote, respectivamente). Las propias etiquetas de clase deben ser un `torch.LongTensor` de longitud `(number of bounding boxes in the image,)` y las cajas un `torch.Tensor` de forma `(number of bounding boxes in the image, 4)`.
**Devuelve:** `DeformableDetrObjectDetectionOutput` o `tuple(torch.Tensor)`
Un `DeformableDetrObjectDetectionOutput` o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración (`None`) y las entradas.
El método forward de [DeformableDetrForObjectDetection](/docs/transformers/v5.23.0/es/model_doc/deformable_detr#transformers.DeformableDetrForObjectDetection) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, devuelta cuando se proporcionan `labels`) -- Pérdida total como combinación lineal de una log-verosimilitud negativa (entropía cruzada) para la predicción de clases y una pérdida de caja delimitadora. Esta última se define como una combinación lineal de la pérdida L1 y la pérdida de IoU generalizada e invariante a la escala.
- **loss_dict** (`Dict`, *opcional*) -- Un diccionario que contiene las pérdidas individuales. Útil para el registro.
- **logits** (`torch.Tensor` de forma `(batch_size, num_queries, num_classes + 1)`) -- Logits de clasificación (incluyendo no-objeto) para todas las consultas.
- **pred_boxes** (`torch.Tensor` de forma `(batch_size, num_queries, 4)`) -- Coordenadas de cajas normalizadas para todas las consultas, representadas como (center_x, center_y, width, height). Estos valores están normalizados en [0, 1], relativos al tamaño de cada imagen individual del lote (ignorando el posible relleno). Puede usar `~DeformableDetrProcessor.post_process_object_detection` para recuperar las cajas delimitadoras no normalizadas.
- **auxiliary_outputs** (`list[Dict]`, *opcional*) -- Opcional, solo se devuelve cuando se activan las pérdidas auxiliares (es decir, `config.auxiliary_loss` está establecido en `True`) y se proporcionan etiquetas. Es una lista de diccionarios que contienen las dos claves anteriores (`logits` y `pred_boxes`) para cada capa del decodificador.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, num_queries, hidden_size)`, *opcional*) -- Secuencia de estados ocultos en la salida de la última capa del decodificador del modelo.
- **decoder_hidden_states** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del decodificador en la salida de cada capa más las salidas de la incrustación inicial.
- **decoder_attentions** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención del decodificador, después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
- **cross_attentions** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención de la capa de atención cruzada del decodificador, después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de atención cruzada.
- **encoder_last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) -- Secuencia de estados ocultos en la salida de la última capa del codificador del modelo.
- **encoder_hidden_states** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de las incrustaciones, si el modelo tiene una capa de incrustaciones, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del codificador en la salida de cada capa más las salidas de la incrustación inicial.
- **encoder_attentions** (`tuple[torch.Tensor]`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención del codificador, después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
- **init_reference_points** (`torch.Tensor` de forma `(batch_size, num_queries, 4)`) -- Puntos de referencia iniciales enviados a través del decodificador Transformer.
- **intermediate_hidden_states** (`torch.Tensor` de forma `(batch_size, config.decoder_layers, num_queries, hidden_size)`) -- Estados ocultos intermedios apilados (salida de cada capa del decodificador).
- **intermediate_reference_points** (`torch.Tensor` de forma `(batch_size, config.decoder_layers, num_queries, 4)`) -- Puntos de referencia intermedios apilados (puntos de referencia de cada capa del decodificador).
- **enc_outputs_class** (`torch.Tensor` de forma `(batch_size, sequence_length, config.num_labels)`, *opcional*, devuelto cuando `config.with_box_refine=True` y `config.two_stage=True`) -- Puntuaciones de las cajas delimitadoras predichas, donde las `config.two_stage_num_proposals` cajas delimitadoras con mayor puntuación se seleccionan como propuestas de región en la primera etapa. Salida de la clasificación binaria de cajas delimitadoras (es decir, primer plano y fondo).
- **enc_outputs_coord_logits** (`torch.Tensor` de forma `(batch_size, sequence_length, 4)`, *opcional*, se devuelve cuando `config.with_box_refine=True` y `config.two_stage=True`) -- Logits de las coordenadas de las cajas delimitadoras predichas en la primera etapa.
Ejemplos:
```python
>>> from transformers import AutoImageProcessor, DeformableDetrForObjectDetection
>>> from PIL import Image
>>> from huggingface_hub.utils import httpx
>>> from io import BytesIO
>>> url = "http://images.cocodataset.org/val2017/000000039769.jpg"
>>> with httpx.stream("GET", url) as response:
... image = Image.open(BytesIO(response.read()))
>>> image_processor = AutoImageProcessor.from_pretrained("SenseTime/deformable-detr")
>>> model = DeformableDetrForObjectDetection.from_pretrained("SenseTime/deformable-detr")
>>> inputs = image_processor(images=image, return_tensors="pt")
>>> outputs = model(**inputs)
>>> # convert outputs (bounding boxes and class logits) to Pascal VOC format (xmin, ymin, xmax, ymax)
>>> target_sizes = torch.tensor([image.size[::-1]])
>>> results = image_processor.post_process_object_detection(outputs, threshold=0.5, target_sizes=target_sizes)[
... 0
... ]
>>> for score, label, box in zip(results["scores"], results["labels"], results["boxes"]):
... box = [round(i, 2) for i in box.tolist()]
... print(
... f"Detected {model.config.id2label[label.item()]} with confidence "
... f"{round(score.item(), 3)} at location {box}"
... )
Detected cat with confidence 0.8 at location [16.5, 52.84, 318.25, 470.78]
Detected cat with confidence 0.789 at location [342.19, 24.3, 640.02, 372.25]
Detected remote with confidence 0.633 at location [40.79, 72.78, 176.76, 117.25]
```