# YOSO
## Resumen
El modelo YOSO se propuso en [You Only Sample (Almost) Once: Linear Cost Self-Attention Via Bernoulli Sampling](https://huggingface.co/papers/2111.09714) de Zhanpeng Zeng, Yunyang Xiong, Sathya N. Ravi, Shailesh Acharya, Glenn Fung y Vikas Singh. YOSO aproxima la autoatención softmax estándar mediante un esquema de muestreo Bernoulli basado en Localidad Sensitive Hashing (LSH). En principio, todas las variables aleatorias de Bernoulli pueden muestrearse con un solo hash.
El resumen del artículo es el siguiente:
*Los modelos basados en Transformer se utilizan ampliamente en el procesamiento del lenguaje natural (NLP). El mecanismo de autoatención es central en el modelo Transformer, ya que captura las interacciones de pares de tokens en las secuencias de entrada y depende de forma cuadrática de la longitud de la secuencia. Entrenar estos modelos con secuencias más largas es costoso. En este artículo, demostramos que un mecanismo de atención de muestreo Bernoulli basado en Hashing Sensible a la Localidad (LSH) reduce la complejidad cuadrática de dichos modelos a lineal. Evitamos el costo cuadrático al considerar la autoatención como una suma de tokens individuales asociados con variables aleatorias de Bernoulli que, en principio, pueden muestrearse de una sola vez mediante un único hash (aunque en la práctica, este número puede ser una constante pequeña). Esto conduce a un esquema de muestreo eficiente para estimar la autoatención, que se basa en modificaciones específicas de LSH (para permitir su despliegue en arquitecturas GPU). Evaluamos nuestro algoritmo en el benchmark GLUE con una longitud de secuencia estándar de 512, donde observamos un rendimiento favorable en comparación con un Transformer preentrenado estándar. En el benchmark Long Range Arena (LRA), para evaluar el rendimiento en secuencias largas, nuestro método logra resultados coherentes con la autoatención softmax, pero con aumentos de velocidad y ahorros de memoria significativos, y a menudo supera a otros métodos de autoatención eficientes. Nuestro código está disponible en this https URL*
Este modelo fue aportado por [novice03](https://huggingface.co/novice03). El código original se puede encontrar [aquí](https://github.com/mlpen/YOSO).
## Consejos de uso
- El algoritmo de atención YOSO se implementa mediante kernels de CUDA personalizados, funciones escritas en CUDA C++ que pueden ejecutarse múltiples veces
en paralelo en una GPU.
- Los kernels proporcionan una función `fast_hash`, que aproxima las proyecciones aleatorias de las consultas y las claves mediante la Transformada Rápida de Hadamard. Usando estas
los códigos de hash, la función `lsh_cumulation` aproxima la autoatención mediante muestreo de Bernoulli basado en LSH.
- Para usar los kernels personalizados, el usuario debe establecer `config.use_expectation = False`. Para asegurarse de que los kernels se compilen correctamente,
el usuario debe instalar la versión correcta de PyTorch y cudatoolkit. De forma predeterminada, `config.use_expectation = True`, lo que utiliza YOSO-E y no requiere compilar kernels de CUDA.
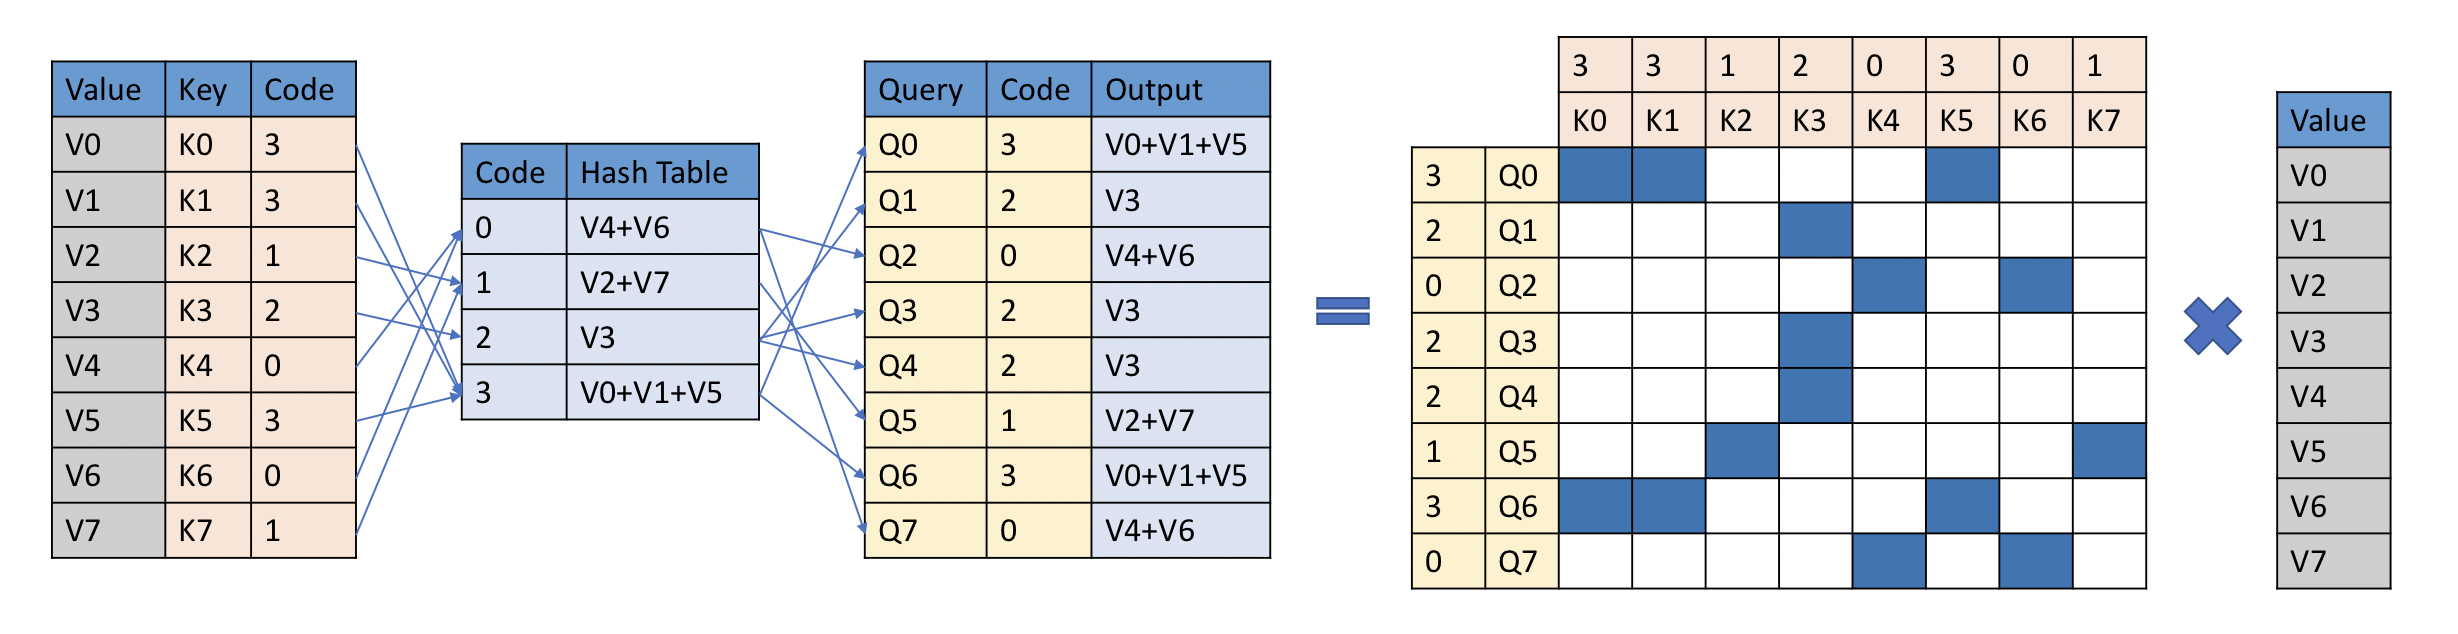 Algoritmo de atención YOSO. Tomado del artículo original.
## Recursos
- [Guía de la tarea de clasificación de texto](../tasks/sequence_classification)
- [Guía de la tarea de clasificación de tokens](../tasks/token_classification)
- [Guía de la tarea de respuesta a preguntas](../tasks/question_answering)
- [Guía de la tarea de modelado de lenguaje enmascarado](../tasks/masked_language_modeling)
- [Guía de tareas de selección múltiple](../tasks/multiple_choice)
## YosoConfig[[transformers.YosoConfig]]
#### transformers.YosoConfig[[transformers.YosoConfig]]
```python
transformers.YosoConfig(transformers_version: str | None = None, architectures: list[str] | None = None, output_hidden_states: bool | None = False, return_dict: bool | None = True, dtype: str | torch.dtype | None = None, chunk_size_feed_forward: int = 0, is_encoder_decoder: bool = False, id2label: dict[int, str] | dict[str, str] | None = None, label2id: dict[str, int] | dict[str, str] | None = None, problem_type: Literal['regression', 'single_label_classification', 'multi_label_classification'] | None = None, vocab_size: int = 50265, hidden_size: int = 768, num_hidden_layers: int = 12, num_attention_heads: int = 12, intermediate_size: int = 3072, hidden_act: str = 'gelu', hidden_dropout_prob: float | int = 0.1, attention_probs_dropout_prob: float | int = 0.1, max_position_embeddings: int = 4096, type_vocab_size: int = 1, initializer_range: float = 0.02, layer_norm_eps: float = 1e-12, use_expectation: bool = True, hash_code_len: int = 9, num_hash: int = 64, conv_window: int | None = None, use_fast_hash: bool = True, lsh_backward: bool = True, pad_token_id: int | None = 1, bos_token_id: int | None = 0, eos_token_id: int | list[int] | None = 2, add_cross_attention: bool = False, tie_word_embeddings: bool = True)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/configuration_yoso.py#L24)
**Parámetros:**
vocab_size (`int`, *opcional*, valor predeterminado `50265`) : Tamaño del vocabulario del modelo. Define el número de tokens diferentes que pueden representarse mediante `input_ids`.
hidden_size (`int`, *opcional*, valor predeterminado `768`) : Dimensión de las representaciones ocultas.
num_hidden_layers (`int`, *opcional*, valor predeterminado `12`) : Número de capas ocultas en el decodificador del Transformer.
num_attention_heads (`int`, *opcional*, valor predeterminado `12`) : Número de cabezas de atención para cada capa de atención en el decodificador Transformer.
intermediate_size (`int`, *opcional*, valor predeterminado `3072`) : Dimensión de las representaciones MLP.
hidden_act (`str`, *opcional*, valor predeterminado `gelu`) : La función de activación no lineal (función o cadena) en el decodificador. Por ejemplo, `"gelu"`, `"relu"`, `"silu"`, etc.
hidden_dropout_prob (`Union[float, int]`, *opcional*, valor predeterminado `0.1`) : La probabilidad de dropout para todas las capas totalmente conectadas en los embeddings, el codificador y el pooler.
attention_probs_dropout_prob (`Union[float, int]`, *opcional*, valor predeterminado `0.1`) : La proporción de dropout para las probabilidades de atención.
max_position_embeddings (`int`, *opcional*, valor predeterminado `4096`) : La longitud máxima de secuencia con la que se podría utilizar este modelo.
type_vocab_size (`int`, *opcional*, valor predeterminado `1`) : El tamaño del vocabulario de `token_type_ids`.
initializer_range (`float`, *opcional*, valor predeterminado `0.02`) : La desviación estándar de truncated_normal_initializer para inicializar todas las matrices de pesos.
layer_norm_eps (`float`, *opcional*, valor predeterminado `1e-12`) : El epsilon utilizado por las capas de normalización de capas.
use_expectation (`bool`, *opcional*, valor predeterminado `True`) : Indica si se debe usar la Expectación YOSO. Anula cualquier efecto de num_hash.
hash_code_len (`int`, *opcional*, valor predeterminado 9) : La longitud de los hashes generados por las funciones de hash.
num_hash (`int`, *opcional*, valor predeterminado 64) : Número de funciones hash utilizadas en `YosoSelfAttention`.
conv_window (`int`, *opcional*) : Tamaño del kernel de la convolución depth-wise.
use_fast_hash (`bool`, *opcional*, valor predeterminado `False`) : Indica si se deben usar kernels de cuda personalizados que realizan una proyección aleatoria rápida mediante la transformación de hadamard.
lsh_backward (`bool`, *opcional*, valor predeterminado `True`) : Indica si se debe o no realizar la retropropagación utilizando el hash sensible a la localidad.
pad_token_id (`int`, *opcional*, valor predeterminado `1`) : Id de token utilizado para el relleno en el vocabulario.
bos_token_id (`int`, *opcional*, valor predeterminado `0`) : Id de token utilizado para el inicio de la secuencia en el vocabulario.
eos_token_id (`Union[int, list[int]]`, *opcional*, valor predeterminado `2`) : Identificador de token utilizado para el fin de la secuencia en el vocabulario.
add_cross_attention (`bool`, *opcional*, valor predeterminado `False`) : Si se deben añadir capas de atención cruzada al modelo.
tie_word_embeddings (`bool`, *opcional*, valor predeterminado `True`) : Indica si se deben vincular las incrustaciones de pesos según el mapeo `tied_weights_keys` del modelo.
Esta es la clase de configuración para almacenar la configuración de un YosoModel. Se utiliza para instanciar un modelo Yoso según los argumentos especificados, definiendo la arquitectura del modelo. Instanciar una configuración con los valores predeterminados producirá una configuración similar a la de [uw-madison/yoso-4096](https://huggingface.co/uw-madison/yoso-4096)
Los objetos de configuración heredan de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) y se pueden utilizar para controlar las salidas del modelo. Consulte la documentación de [PreTrainedConfig](/docs/transformers/v5.23.0/es/main_classes/configuration#transformers.PreTrainedConfig) para obtener más información.
Ejemplo:
```python
>>> from transformers import YosoConfig, YosoModel
>>> # Initializing a YOSO uw-madison/yoso-4096 style configuration
>>> configuration = YosoConfig()
>>> # Initializing a model (with random weights) from the uw-madison/yoso-4096 style configuration
>>> model = YosoModel(configuration)
>>> # Accessing the model configuration
>>> configuration = model.config
```
## YosoModel[[transformers.YosoModel]]
#### transformers.YosoModel[[transformers.YosoModel]]
```python
transformers.YosoModel(config: YosoConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L616)
**Parámetros:**
config ([YosoConfig](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo Yoso sin procesar, que genera estados ocultos crudos sin ninguna cabeza específica en la parte superior.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.YosoModel.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L633)
**Parámetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
output_attentions (`bool`, *opcional*) : Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulte `attentions` en los tensores devueltos para obtener más detalles.
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** [BaseModelOutputWithCrossAttentions](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithCrossAttentions) o `tuple(torch.Tensor)`
Un [BaseModelOutputWithCrossAttentions](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.BaseModelOutputWithCrossAttentions) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([YosoConfig](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoConfig)) y las entradas.
El método forward de [YosoModel](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoModel) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **last_hidden_state** (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`) -- Secuencia de estados ocultos en la salida de la última capa del modelo.
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
- **cross_attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` y `config.add_cross_attention=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención de la capa de atención cruzada del decodificador, después del softmax de atención, utilizados para calcular la media ponderada en las cabezas de atención cruzada.
## YosoForMaskedLM[[transformers.YosoForMaskedLM]]
#### transformers.YosoForMaskedLM[[transformers.YosoForMaskedLM]]
```python
transformers.YosoForMaskedLM(config: YosoConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L703)
**Parámetros:**
config ([YosoConfig](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo Yoso con una cabeza de `language modeling` en la parte superior."
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.YosoForMaskedLM.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L725)
**Parámetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Etiquetas para calcular la pérdida de modelado de lenguaje enmascarado. Los índices deben estar en `[-100, 0, ..., config.vocab_size]` (ver la docstring de `input_ids`). Los tokens con índices establecidos en `-100` se ignoran (se enmascaran); la pérdida solo se calcula para los tokens con etiquetas en `[0, ..., config.vocab_size]`.
output_attentions (`bool`, *opcional*) : Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulte `attentions` en los tensores devueltos para obtener más detalles.
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** [MaskedLMOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) o `tuple(torch.Tensor)`
Un [MaskedLMOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.MaskedLMOutput) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([YosoConfig](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoConfig)) y las entradas.
El método forward de [YosoForMaskedLM](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoForMaskedLM) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, se devuelve cuando se proporciona `labels`) -- Pérdida de modelado de lenguaje enmascarado (MLM).
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.vocab_size)`) -- Puntuaciones de predicción de la cabeza de modelado de lenguaje (puntuaciones para cada token del vocabulario antes de SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplo:
```python
>>> from transformers import AutoTokenizer, YosoForMaskedLM
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForMaskedLM.from_pretrained("uw-madison/yoso-4096")
>>> inputs = tokenizer("The capital of France is .", return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> # retrieve index of
>>> mask_token_index = (inputs.input_ids == tokenizer.mask_token_id)[0].nonzero(as_tuple=True)[0]
>>> predicted_token_id = logits[0, mask_token_index].argmax(axis=-1)
>>> tokenizer.decode(predicted_token_id)
...
>>> labels = tokenizer("The capital of France is Paris.", return_tensors="pt")["input_ids"]
>>> # mask labels of non- tokens
>>> labels = torch.where(inputs.input_ids == tokenizer.mask_token_id, labels, -100)
>>> outputs = model(**inputs, labels=labels)
>>> round(outputs.loss.item(), 2)
...
```
## YosoForSequenceClassification[[transformers.YosoForSequenceClassification]]
#### transformers.YosoForSequenceClassification[[transformers.YosoForSequenceClassification]]
```python
transformers.YosoForSequenceClassification(config: YosoConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L799)
**Parámetros:**
config ([YosoConfig](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
Transformador del modelo YOSO con una cabeza de clasificación/regresión de secuencias en la parte superior (una capa lineal sobre la salida agrupada), por ejemplo, para tareas GLUE.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.YosoForSequenceClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L809)
**Parámetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Etiquetas para calcular la pérdida de clasificación/regresión de secuencia. Los índices deben estar en `[0, ..., config.num_labels - 1]`. Si `config.num_labels == 1` se calcula una pérdida de regresión (pérdida de error cuadrático medio), si `config.num_labels > 1` se calcula una pérdida de clasificación (entropía cruzada).
output_attentions (`bool`, *opcional*) : Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulte `attentions` en los tensores devueltos para obtener más detalles.
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** [SequenceClassifierOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) o `tuple(torch.Tensor)`
Un [SequenceClassifierOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.SequenceClassifierOutput) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([YosoConfig](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoConfig)) y las entradas.
El método forward de [YosoForSequenceClassification](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoForSequenceClassification) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, se devuelve cuando se proporciona `labels`) -- Pérdida de clasificación (o de regresión si config.num_labels==1).
- **logits** (`torch.Tensor` de forma `(batch_size, config.num_labels)`) -- Puntuaciones de clasificación (o de regresión si config.num_labels==1) (antes de SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplo de clasificación de una sola etiqueta:
```python
>>> import torch
>>> from transformers import AutoTokenizer, YosoForSequenceClassification
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096")
>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_id = logits.argmax().item()
>>> model.config.id2label[predicted_class_id]
...
>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096", num_labels=num_labels)
>>> labels = torch.tensor([1])
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
```
Ejemplo de clasificación multietiqueta:
```python
>>> import torch
>>> from transformers import AutoTokenizer, YosoForSequenceClassification
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForSequenceClassification.from_pretrained("uw-madison/yoso-4096", problem_type="multi_label_classification")
>>> inputs = tokenizer("Hello, my dog is cute", return_tensors="pt")
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_class_ids = torch.arange(0, logits.shape[-1])[torch.sigmoid(logits).squeeze(dim=0) > 0.5]
>>> # To train a model on `num_labels` classes, you can pass `num_labels=num_labels` to `.from_pretrained(...)`
>>> num_labels = len(model.config.id2label)
>>> model = YosoForSequenceClassification.from_pretrained(
... "uw-madison/yoso-4096", num_labels=num_labels, problem_type="multi_label_classification"
... )
>>> labels = torch.sum(
... torch.nn.functional.one_hot(predicted_class_ids[None, :].clone(), num_classes=num_labels), dim=1
... ).to(torch.float)
>>> loss = model(**inputs, labels=labels).loss
```
## YosoForMultipleChoice[[transformers.YosoForMultipleChoice]]
#### transformers.YosoForMultipleChoice[[transformers.YosoForMultipleChoice]]
```python
transformers.YosoForMultipleChoice(config: YosoConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L874)
**Parámetros:**
config ([YosoConfig](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El modelo Yoso con una cabeza de clasificación de opción múltiple en la parte superior (una capa lineal sobre la salida agrupada y un softmax), por ejemplo, para las tareas RocStories/SWAG.
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.YosoForMultipleChoice.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L885)
**Parámetros:**
input_ids (`torch.LongTensor` de forma `(batch_size, num_choices, sequence_length)`) : Índices de los tokens de la secuencia de entrada en el vocabulario. Los índices se pueden obtener usando [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.LongTensor` de forma `(batch_size, num_choices, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.LongTensor` de forma `(batch_size, num_choices, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.max_position_embeddings - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, num_choices, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de *input_ids* en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
labels (`torch.LongTensor` de forma `(batch_size,)`, *opcional*) : Etiquetas para calcular la pérdida de clasificación de opción múltiple. Los índices deben estar en `[0, ..., num_choices-1]`, donde `num_choices` es el tamaño de la segunda dimensión de los tensores de entrada. (Véase `input_ids` arriba)
output_attentions (`bool`, *opcional*) : Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulte `attentions` en los tensores devueltos para obtener más detalles.
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** [MultipleChoiceModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.MultipleChoiceModelOutput) o `tuple(torch.Tensor)`
Un [MultipleChoiceModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.MultipleChoiceModelOutput) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([YosoConfig](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoConfig)) y las entradas.
El método forward de [YosoForMultipleChoice](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoForMultipleChoice) sobrescribe el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma *(1,)*, *opcional*, se devuelve cuando se proporciona `labels`) -- Pérdida de clasificación.
- **logits** (`torch.Tensor` de forma `(batch_size, num_choices)`) -- *num_choices* es la segunda dimensión de los tensores de entrada. (ver *input_ids* arriba).
Puntuaciones de clasificación (antes de SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplo:
```python
>>> from transformers import AutoTokenizer, YosoForMultipleChoice
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForMultipleChoice.from_pretrained("uw-madison/yoso-4096")
>>> prompt = "In Italy, pizza served in formal settings, such as at a restaurant, is presented unsliced."
>>> choice0 = "It is eaten with a fork and a knife."
>>> choice1 = "It is eaten while held in the hand."
>>> labels = torch.tensor(0).unsqueeze(0) # choice0 is correct (according to Wikipedia ;)), batch size 1
>>> encoding = tokenizer([prompt, prompt], [choice0, choice1], return_tensors="pt", padding=True)
>>> outputs = model(**{k: v.unsqueeze(0) for k, v in encoding.items()}, labels=labels) # batch size is 1
>>> # the linear classifier still needs to be trained
>>> loss = outputs.loss
>>> logits = outputs.logits
```
## YosoForTokenClassification[[transformers.YosoForTokenClassification]]
#### transformers.YosoForTokenClassification[[transformers.YosoForTokenClassification]]
```python
transformers.YosoForTokenClassification(config: YosoConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L975)
**Parámetros:**
config ([YosoConfig](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El transformador Yoso con una cabeza de clasificación de tokens en la parte superior (una capa lineal sobre la salida de los estados ocultos), por ejemplo, para tareas de reconocimiento de entidades nombradas (NER).
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.YosoForTokenClassification.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, labels: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L987)
**Parámetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
labels (`torch.LongTensor` de forma `(batch_size, sequence_length)`, *opcional*) : Etiquetas para calcular la pérdida de clasificación de tokens. Los índices deben estar en `[0, ..., config.num_labels - 1]`.
output_attentions (`bool`, *opcional*) : Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulte `attentions` en los tensores devueltos para obtener más detalles.
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** [TokenClassifierOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) o `tuple(torch.Tensor)`
Un [TokenClassifierOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.TokenClassifierOutput) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([YosoConfig](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoConfig)) y las entradas.
El método forward de [YosoForTokenClassification](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoForTokenClassification) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, se devuelve cuando se proporciona `labels`) -- Pérdida de clasificación.
- **logits** (`torch.Tensor` de forma `(batch_size, sequence_length, config.num_labels)`) -- Puntuaciones de clasificación (antes de SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplo:
```python
>>> from transformers import AutoTokenizer, YosoForTokenClassification
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForTokenClassification.from_pretrained("uw-madison/yoso-4096")
>>> inputs = tokenizer(
... "HuggingFace is a company based in Paris and New York", add_special_tokens=False, return_tensors="pt"
... )
>>> with torch.no_grad():
... logits = model(**inputs).logits
>>> predicted_token_class_ids = logits.argmax(-1)
>>> # Note that tokens are classified rather then input words which means that
>>> # there might be more predicted token classes than words.
>>> # Multiple token classes might account for the same word
>>> predicted_tokens_classes = [model.config.id2label[t.item()] for t in predicted_token_class_ids[0]]
>>> predicted_tokens_classes
...
>>> labels = predicted_token_class_ids
>>> loss = model(**inputs, labels=labels).loss
>>> round(loss.item(), 2)
...
```
## YosoForQuestionAnswering[[transformers.YosoForQuestionAnswering]]
#### transformers.YosoForQuestionAnswering[[transformers.YosoForQuestionAnswering]]
```python
transformers.YosoForQuestionAnswering(config: YosoConfig)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L1046)
**Parámetros:**
config ([YosoConfig](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoConfig)) : Clase de configuración del modelo con todos los parámetros del modelo. Inicializar con un archivo de configuración no carga los pesos asociados con el modelo, solo la configuración. Consulte el método [from_pretrained()](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel.from_pretrained) para cargar los pesos del modelo.
El transformador Yoso con una cabeza de clasificación de tramos en la parte superior para tareas de respuesta a preguntas extractivas como SQuAD (una capa lineal sobre la salida de los estados ocultos para calcular `span start logits` y `span end logits`).
Este modelo hereda de [PreTrainedModel](/docs/transformers/v5.23.0/es/main_classes/model#transformers.PreTrainedModel). Consulte la documentación de la clase superior para los métodos genéricos que la biblioteca implementa para todos sus modelos (como la descarga o el guardado, el redimensionamiento de las incrustaciones de entrada, la poda de cabezas, etc.).
Este modelo también es una subclase de [torch.nn.Module](https://pytorch.org/docs/stable/nn.html#torch.nn.Module) de PyTorch. Úsalo como un módulo de PyTorch regular y consulta la documentación de PyTorch para todo lo relacionado con el uso y el comportamiento generales.
#### forward[[transformers.YosoForQuestionAnswering.forward]]
```python
forward(input_ids: typing.Optional[torch.Tensor] = None, attention_mask: typing.Optional[torch.Tensor] = None, token_type_ids: typing.Optional[torch.Tensor] = None, position_ids: typing.Optional[torch.Tensor] = None, inputs_embeds: typing.Optional[torch.Tensor] = None, start_positions: typing.Optional[torch.Tensor] = None, end_positions: typing.Optional[torch.Tensor] = None, output_attentions: bool | None = None, output_hidden_states: bool | None = None, return_dict: bool | None = None, **kwargs)
```
[Fuente](https://github.com/huggingface/transformers/blob/v5.23.0/src/transformers/models/yoso/modeling_yoso.py#L1059)
**Parámetros:**
input_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de los tokens de la secuencia de entrada en el vocabulario. El relleno se ignorará de forma predeterminada. Los índices se pueden obtener mediante [AutoTokenizer](/docs/transformers/v5.23.0/es/model_doc/auto#transformers.AutoTokenizer). Consulte [PreTrainedTokenizer.encode()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.encode) y [PreTrainedTokenizer.__call__()](/docs/transformers/v5.23.0/es/internal/tokenization_utils#transformers.PreTrainedTokenizerBase.__call__) para obtener más detalles. [¿Qué son los IDs de entrada?](../glossary#input-ids)
attention_mask (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Máscara para evitar realizar atención en los índices de tokens de relleno. Valores de la máscara seleccionados en `[0, 1]`: - 1 para tokens que **no están enmascarados**, - 0 para tokens que **están enmascarados**. [¿Qué son las máscaras de atención?](../glossary#attention-mask)
token_type_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de tokens de segmento para indicar las primeras y segundas partes de las entradas. Los índices se seleccionan en `[0, 1]`: - 0 corresponde a un token de *oración A*, - 1 corresponde a un token de *oración B*. [¿Qué son los IDs de tipo de token?](../glossary#token-type-ids)
position_ids (`torch.Tensor` de forma `(batch_size, sequence_length)`, *opcional*) : Índices de las posiciones de los tokens de cada secuencia de entrada en las incrustaciones de posición. Seleccionados en el rango `[0, config.n_positions - 1]`. [¿Qué son los IDs de posición?](../glossary#position-ids)
inputs_embeds (`torch.Tensor` de forma `(batch_size, sequence_length, hidden_size)`, *opcional*) : Opcionalmente, en lugar de pasar `input_ids`, puedes elegir pasar directamente una representación incrustada. Esto es útil si deseas tener más control sobre cómo convertir los índices de `input_ids` en los vectores asociados que en la matriz de búsqueda de incrustaciones interna del modelo.
start_positions (`torch.Tensor` de forma `(batch_size,)`, *opcional*) : Etiquetas para la posición (índice) del inicio del tramo etiquetado para calcular la pérdida de clasificación de tokens. Las posiciones se limitan a la longitud de la secuencia (`sequence_length`). Las posiciones fuera de la secuencia no se tienen en cuenta para calcular la pérdida.
end_positions (`torch.Tensor` de forma `(batch_size,)`, *opcional*) : Etiquetas para la posición (índice) del final del tramo etiquetado para calcular la pérdida de clasificación de tokens. Las posiciones se limitan a la longitud de la secuencia (`sequence_length`). Las posiciones fuera de la secuencia no se tienen en cuenta para calcular la pérdida.
output_attentions (`bool`, *opcional*) : Indica si se deben devolver los tensores de atención de todas las capas de atención. Consulte `attentions` en los tensores devueltos para obtener más detalles.
output_hidden_states (`bool`, *opcional*) : Indica si se deben devolver los estados ocultos de todas las capas. Consulte `hidden_states` en los tensores devueltos para obtener más detalles.
return_dict (`bool`, *opcional*) : Indica si se debe devolver un [ModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.utils.ModelOutput) en lugar de una tupla simple.
**Devuelve:** [QuestionAnsweringModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) o `tuple(torch.Tensor)`
Un [QuestionAnsweringModelOutput](/docs/transformers/v5.23.0/es/main_classes/output#transformers.modeling_outputs.QuestionAnsweringModelOutput) o una tupla de `torch.Tensor` (si se pasa `return_dict=False` o cuando `config.return_dict=False`) que comprende varios elementos según la configuración ([YosoConfig](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoConfig)) y las entradas.
El método forward de [YosoForQuestionAnswering](/docs/transformers/v5.23.0/es/model_doc/yoso#transformers.YosoForQuestionAnswering) reemplaza el método especial `__call__`.
Aunque la receta para la pasada hacia adelante debe definirse dentro de esta función, se debe llamar a la instancia de `Module` después, en lugar de a esta, ya que la primera se encarga de ejecutar los pasos de preprocesamiento y posprocesamiento, mientras que la segunda los ignora silenciosamente.
- **loss** (`torch.Tensor` de forma `(1,)`, *opcional*, se devuelve cuando se proporciona `labels`) -- La pérdida total de extracción de tramos es la suma de una Entropía Cruzada para las posiciones de inicio y fin.
- **start_logits** (`torch.Tensor` de forma `(batch_size, sequence_length)`) -- Puntuaciones de inicio de tramo (antes de SoftMax).
- **end_logits** (`torch.Tensor` de forma `(batch_size, sequence_length)`) -- Puntuaciones de fin de tramo (antes de SoftMax).
- **hidden_states** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_hidden_states=True` o cuando `config.output_hidden_states=True`) -- Tupla de `torch.Tensor` (una para la salida de los embeddings, si el modelo tiene una capa de embedding, + una para la salida de cada capa) de forma `(batch_size, sequence_length, hidden_size)`.
Estados ocultos del modelo en la salida de cada capa más las salidas opcionales de la incrustación inicial.
- **attentions** (`tuple(torch.Tensor)`, *opcional*, se devuelve cuando se pasa `output_attentions=True` o cuando `config.output_attentions=True`) -- Tupla de `torch.Tensor` (una por cada capa) de forma `(batch_size, num_heads, sequence_length, sequence_length)`.
Pesos de atención tras el softmax de atención, utilizados para calcular la media ponderada en las cabezas de autoatención.
Ejemplo:
```python
>>> from transformers import AutoTokenizer, YosoForQuestionAnswering
>>> import torch
>>> tokenizer = AutoTokenizer.from_pretrained("uw-madison/yoso-4096")
>>> model = YosoForQuestionAnswering.from_pretrained("uw-madison/yoso-4096")
>>> question, text = "Who was Jim Henson?", "Jim Henson was a nice puppet"
>>> inputs = tokenizer(question, text, return_tensors="pt")
>>> with torch.no_grad():
... outputs = model(**inputs)
>>> answer_start_index = outputs.start_logits.argmax()
>>> answer_end_index = outputs.end_logits.argmax()
>>> predict_answer_tokens = inputs.input_ids[0, answer_start_index : answer_end_index + 1]
>>> tokenizer.decode(predict_answer_tokens, skip_special_tokens=True)
...
>>> # target is "nice puppet"
>>> target_start_index = torch.tensor([14])
>>> target_end_index = torch.tensor([15])
>>> outputs = model(**inputs, start_positions=target_start_index, end_positions=target_end_index)
>>> loss = outputs.loss
>>> round(loss.item(), 2)
...
```