
Hub documentation
Потоковые наборы данных
Потоковые наборы данных
Интегрированные библиотеки
If a dataset on the Hub is compatible with a supported library that allows streaming from Hugging Face, streaming the dataset can be done in just a few lines. For information on accessing the dataset, you can click on the “Use this dataset” button on the dataset page to see how to do so. For example, knkarthick/samsum shows how to do so with datasets below.


Использование клиентской библиотеки Hugging Face
Вы можете использовать библиотеку huggingface_hub для создания, удаления и доступа к файлам в репозиториях. Например, чтобы стримить датасет allenai/c4 в Python, просто установите библиотеку (рекомендуем использовать последнюю версию) и выполните следующий код.
pip install -U huggingface_hub
from huggingface_hub import hffs

repo_id = "allenai/c4"
path_in_repo = "en/c4-train.00000-of-01024.json.gz"

# Stream the file
with hffs.open(f"datasets/{repo_id}/{path_in_repo}", "r", compression="gzip") as f:
    print(f.readline())  # read only the first line
    # {"text":"Beginners BBQ Class Taking Place in Missoula!...}
См. документацию HfFileSystem для получения дополнительной информации.
Вы также можете интегрировать это в собственную библиотеру! Например, с помощью Pandas можно быстро стримить CSV-датасет батчами.
import pandas as pd

repo_id = "YOUR_REPO_ID"
path_in_repo = "data.csv"

batch_size = 5

# Stream the file
with hffs.open(f"datasets/{repo_id}/{path_in_repo}") as f:
    for df in pd.read_csv(f, iterator=True, chunksize=batch_size):  # read 5 lines at a time
        print(len(df))  # 5
Стриминг особенно полезен для последовательного чтения больших файлов на Hugging Face или чтения только небольшой их части.
Например, tarfile позволяет итерировать по файлам в архивах TAR, zipfile — читать файлы из архивов ZIP, а pyarrow — обращаться к группам строк в файлах Parquet.
В OpenDAL доступна эквивалентная реализация файловой системы на Rust.
Использование cURL
Поскольку все файлы на Hub доступны по HTTP, вы можете загружать файлы потоково с помощью cURL:
>>> curl -L https://huggingface.co/datasets/fka/awesome-chatgpt-prompts/resolve/main/prompts.csv | head -n 5
"act","prompt"
"An Ethereum Developer","Imagine you are an experienced Ethereum developer tasked with creating...
"SEO Prompt","Using WebPilot, create an outline for an article that will be 2,000 words on the ...
"Linux Terminal","I want you to act as a linux terminal. I will type commands and you will repl...
"English Translator and Improver","I want you to act as an English translator, spelling correct...
Используйте запросы диапазона для доступа к конкретной части файла:
>>> curl -r 40-88 -L https://huggingface.co/datasets/fka/awesome-chatgpt-prompts/resolve/main/prompts.csv
Imagine you are an experienced Ethereum developer
Получение данных из частных репозиториев с использованием токена доступа:
>>> export HF_TOKEN=hf_xxx
>>> curl -H "Authorization: Bearer $HF_TOKEN" -L https://huggingface.co/...
Потоковая обработка Parquet
Parquet — отличный формат для наборов данных в области ИИ. Он обеспечивает хорошее сжатие, столбчатую структуру для эффективной обработки и проекций, а также многоуровневые метаданные для быстрой фильтрации, что делает его подходящим для наборов данных любого размера.
Файлы Parquet разделены на группы строк, каждая из которых обычно занимает около 100 МБ. Это позволяет загрузчикам данных и фреймворкам обработки данных потоково читать данные, последовательно обрабатывая группы строк.
Внутри групп строк находятся отдельные столбцы, которые разделены на страницы. Страницы — это сжатые блоки размером около 1 МБ, содержащие фактические данные.
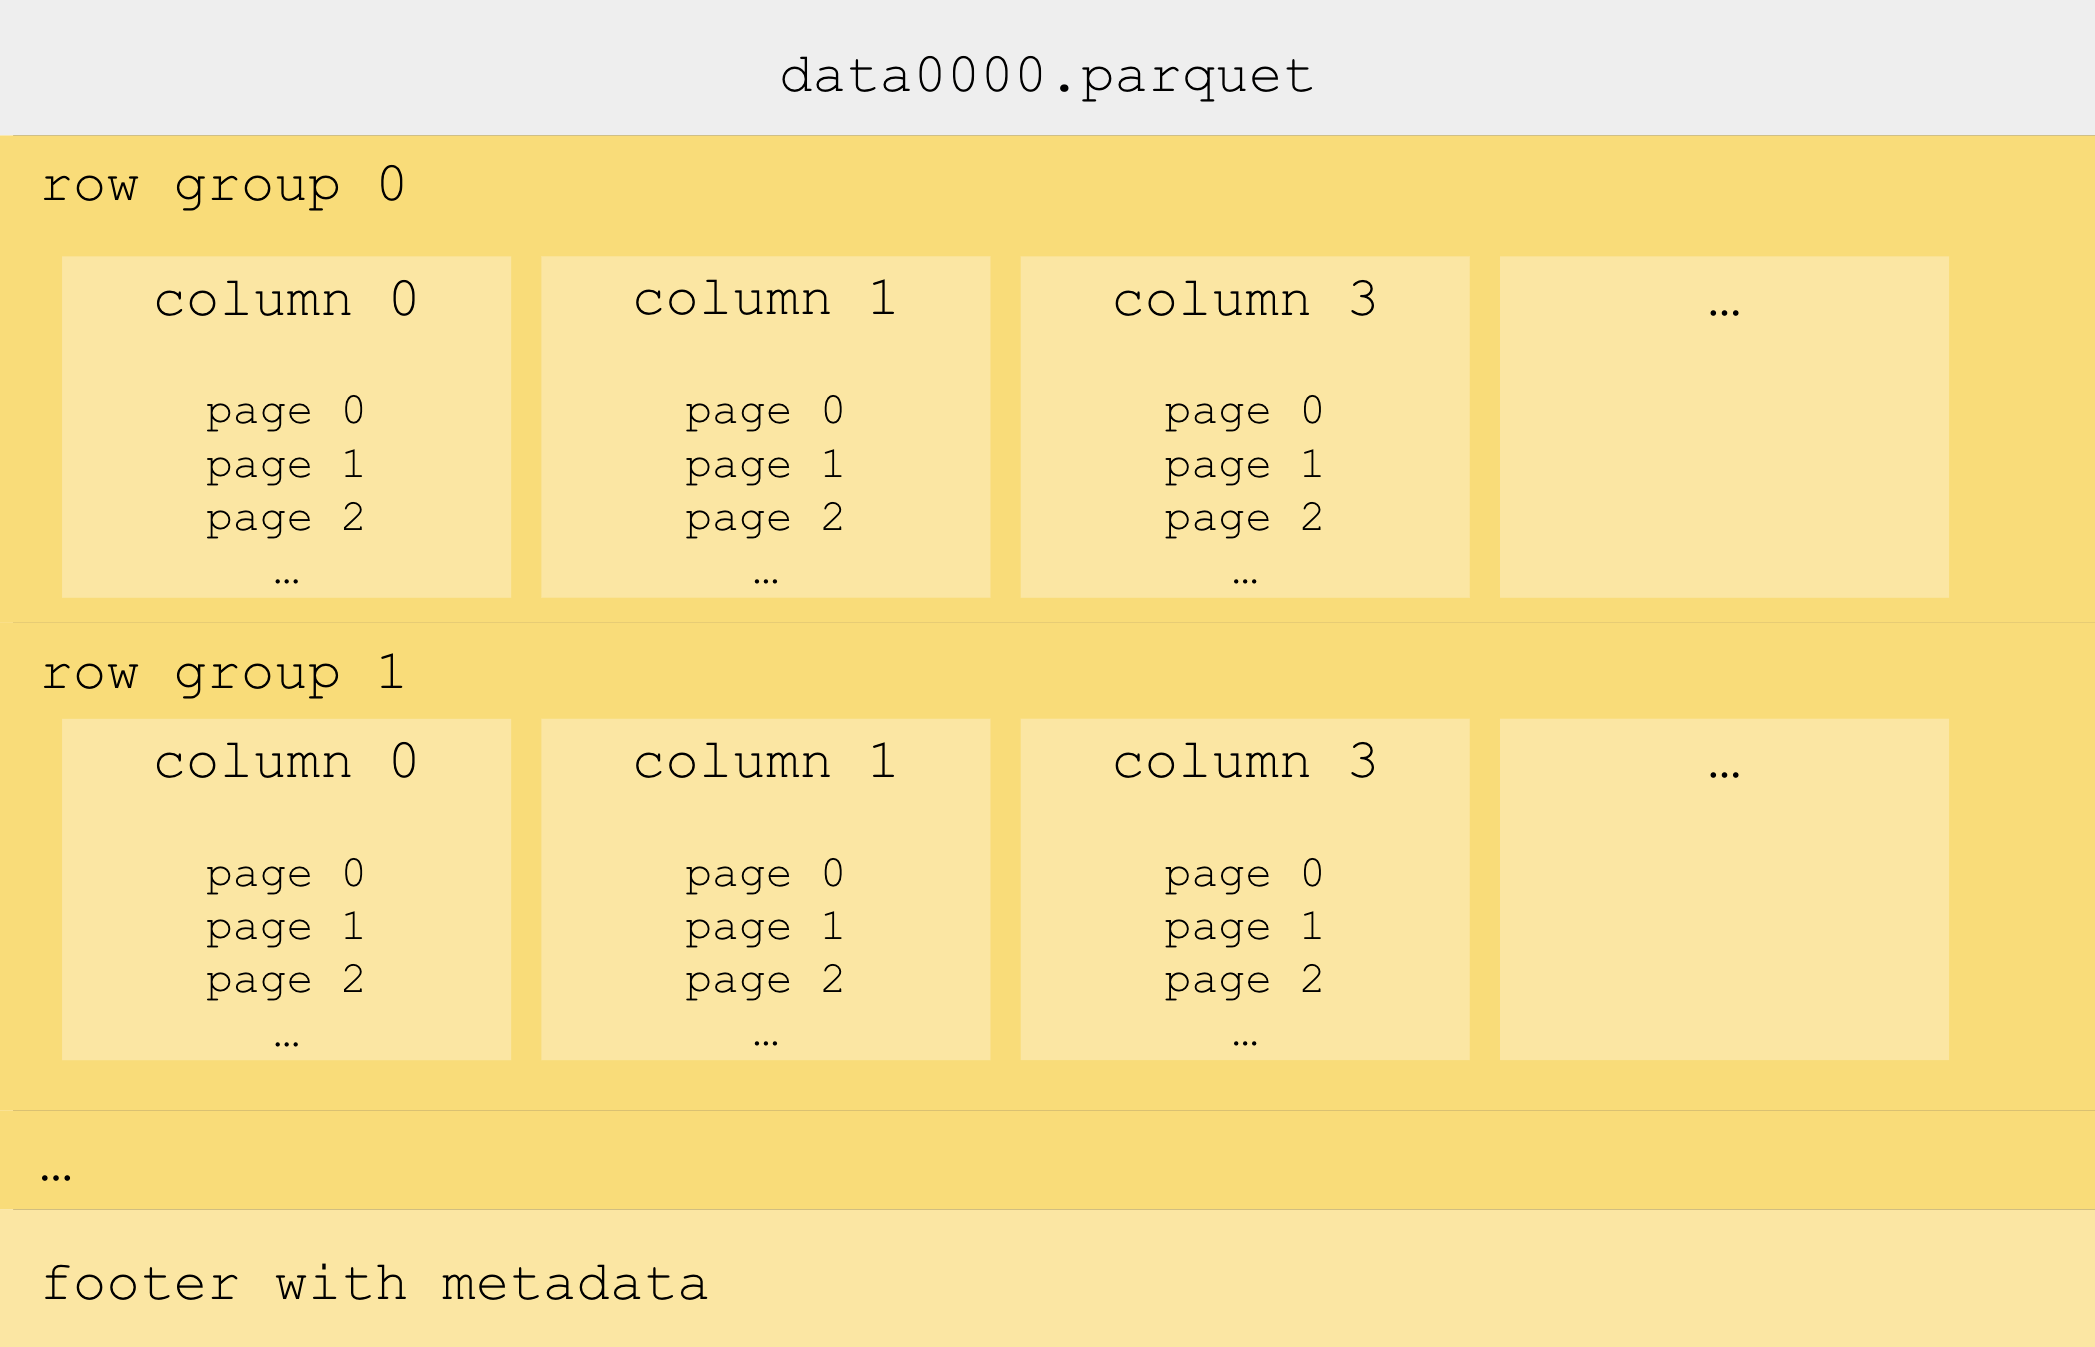
Потоковая передача групп строк
Используйте PyArrow для потоковой передачи групп строк из файлов Parquet на Hugging Face:
import pyarrow.parquet as pq

repo_id = "HuggingFaceFW/finewiki"
path_in_repo = "data/enwiki/000_00000.parquet"

# Stream the Parquet file row group per row group
with pq.ParquetFile(f"hf://datasets/{repo_id}/{path_in_repo}") as pf:
    for row_group_idx in range(pf.num_row_groups):
        row_group_table = pf.read_row_group(row_group_idx)
        df = row_group_table.to_pandas()
PyArrow поддерживает пути
hf://из коробки и автоматически используетHfFileSystem
Подробнее см. в документации PyArrow.
Эффективный случайный доступ
Группы строк дополнительно делятся на столбцы, а столбцы — на страницы. Страницы обычно занимают около 1 МБ и являются наименьшей единицей данных в Parquet, поскольку именно на этом уровне применяется сжатие. Доступ к страницам позволяет загружать конкретные строки без необходимости загрузки всей группы строк; это возможно, если файл Parquet содержит индекс страниц. Однако не все фреймворки Parquet поддерживают чтение на уровне страниц. Например, PyArrow этого не делает, но crate parquet в Rust поддерживает:
use std::sync::Arc;
use object_store::path::Path;
use object_store_opendal::OpendalStore;
use opendal::services::Huggingface;
use opendal::Operator;
use parquet::arrow::async_reader::ParquetObjectReader;
use parquet::arrow::ParquetRecordBatchStreamBuilder;
use futures::TryStreamExt;

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let repo_id = "HuggingFaceFW/finewiki";
    let path_in_repo = Path::from("data/enwiki/000_00000.parquet");
    let offset = 0;
    let limit = 10;

    let builder = Huggingface::default().repo_type("dataset").repo_id(repo_id);
    let operator = Operator::new(builder)?.finish();
    let store = Arc::new(OpendalStore::new(operator));
    let reader = ParquetObjectReader::new(store, path_in_repo.clone());
    let batch_stream =
        ParquetRecordBatchStreamBuilder::new(reader).await?
            .with_offset(offset as usize)
            .with_limit(limit as usize)
            .build()?;
    let results = batch_stream.try_collect::<Vec<_>>().await?;
    println!("Read {} batches", results.len());
    Ok(())
}
В Rust мы используем сервис
Huggingfaceиз OpenDAL, который эквивалентенHfFileSystemв Python
Передайте write_page_index=True в PyArrow, чтобы включить индекс страниц, обеспечивающий эффективный произвольный доступ.
Это, в частности, добавляет «offset_index_offset» и «offset_index_length» в столбцы Parquet, которые можно увидеть в просмотрщике метаданных Parquet на Hugging Face.
Индексы страниц также ускоряют работу просмотрщика датасетов Hugging Face и позволяют отображать данные без ограничения размера группы строк.