
Hub documentation
Akış veri kümeleri
Akış veri kümeleri
Entegre kütüphaneler
Hub'daki bir veri seti, Hugging Face'ten akış (streaming) yapılmasına izin veren desteklenen bir kütüphane ile uyumluysa, veri setinin akışını birkaç satırda gerçekleştirebilirsiniz. Veri setine erişimle ilgili bilgi için, veri seti sayfasındaki “Use this dataset” düğmesine tıklayarak nasıl yapılacağını görebilirsiniz. Örneğin, knkarthick/samsum aşağıda datasets ile nasıl yapılacağını göstermektedir.


Hugging Face İstemci Kütüphanesini Kullanma
huggingface_hub kütüphanesini kullanarak depolardan dosya oluşturabilir, silebilir ve erişebilirsiniz. Örneğin, Python'da allenai/c4 veri setini akış olarak almak için kütüphaneyi (en son sürümü kullanmanızı öneririz) kurup aşağıdaki kodu çalıştırmanız yeterlidir.
pip install -U huggingface_hub
from huggingface_hub import hffs

repo_id = "allenai/c4"
path_in_repo = "en/c4-train.00000-of-01024.json.gz"

# Stream the file
with hffs.open(f"datasets/{repo_id}/{path_in_repo}", "r", compression="gzip") as f:
    print(f.readline())  # read only the first line
    # {"text":"Beginners BBQ Class Taking Place in Missoula!...}
Daha fazla bilgi için HfFileSystem belgelerini inceleyin.
Bunu kendi kütüphanenize de entegre edebilirsiniz! Örneğin, Pandas ile bir CSV veri setini partiler halinde hızlı bir şekilde akışa alabilirsiniz.
import pandas as pd

repo_id = "YOUR_REPO_ID"
path_in_repo = "data.csv"

batch_size = 5

# Stream the file
with hffs.open(f"datasets/{repo_id}/{path_in_repo}") as f:
    for df in pd.read_csv(f, iterator=True, chunksize=batch_size):  # read 5 lines at a time
        print(len(df))  # 5
Streaming, büyük dosyaları Hugging Face üzerinde kademeli olarak veya yalnızca küçük bir bölümünü okumak için özellikle faydalıdır.
Örneğin tarfile TAR arşivlerindeki dosyalar üzerinde yineleme yapabilir, zipfile ZIP arşivlerinden dosyalar okuyabilir ve pyarrow Parquet dosyalarındaki satır gruplarına erişebilir.
Rust'ta OpenDAL içinde kullanılabilir bir eşdeğer dosya sistemi uygulaması mevcuttur.
cURL Kullanma
Hub'daki tüm dosyalar HTTP üzerinden erişilebilir olduğundan, dosyaları cURL kullanarak akış olarak alabilirsiniz:
>>> curl -L https://huggingface.co/datasets/fka/awesome-chatgpt-prompts/resolve/main/prompts.csv | head -n 5
"act","prompt"
"An Ethereum Developer","Imagine you are an experienced Ethereum developer tasked with creating...
"SEO Prompt","Using WebPilot, create an outline for an article that will be 2,000 words on the ...
"Linux Terminal","I want you to act as a linux terminal. I will type commands and you will repl...
"English Translator and Improver","I want you to act as an English translator, spelling correct...
Belirli bir dosya bölümüne erişmek için aralık istekleri kullanın:
>>> curl -r 40-88 -L https://huggingface.co/datasets/fka/awesome-chatgpt-prompts/resolve/main/prompts.csv
Imagine you are an experienced Ethereum developer
Bir erişim belirteci kullanarak özel depolardan akış yapın:
>>> export HF_TOKEN=hf_xxx
>>> curl -H "Authorization: Bearer $HF_TOKEN" -L https://huggingface.co/...
Parquet Akışı
Parquet, yapay zeka veri setleri için harika bir biçimdir. Verimli işleme ve projeksiyonlar için sütun tabanlı bir yapı, hızlı filtreleme için çok seviyeli meta veriler ve iyi bir sıkıştırma sunar; her boyuttaki veri setleri için uygundur.
Parquet dosyaları, genellikle her biri 100MB civarında olan satır gruplarına bölünür. Bu, veri yükleyicilerin ve veri işleme çerçevelerinin satır grupları üzerinde gezinerek verileri kademeli olarak akışa almasını sağlar.
Satır gruplarının içinde, sayfalara bölünmüş bireysel sütunlar bulunur. Sayfalar, gerçek veriyi içeren yaklaşık 1 MB'lık sıkıştırılmış bloklardır.
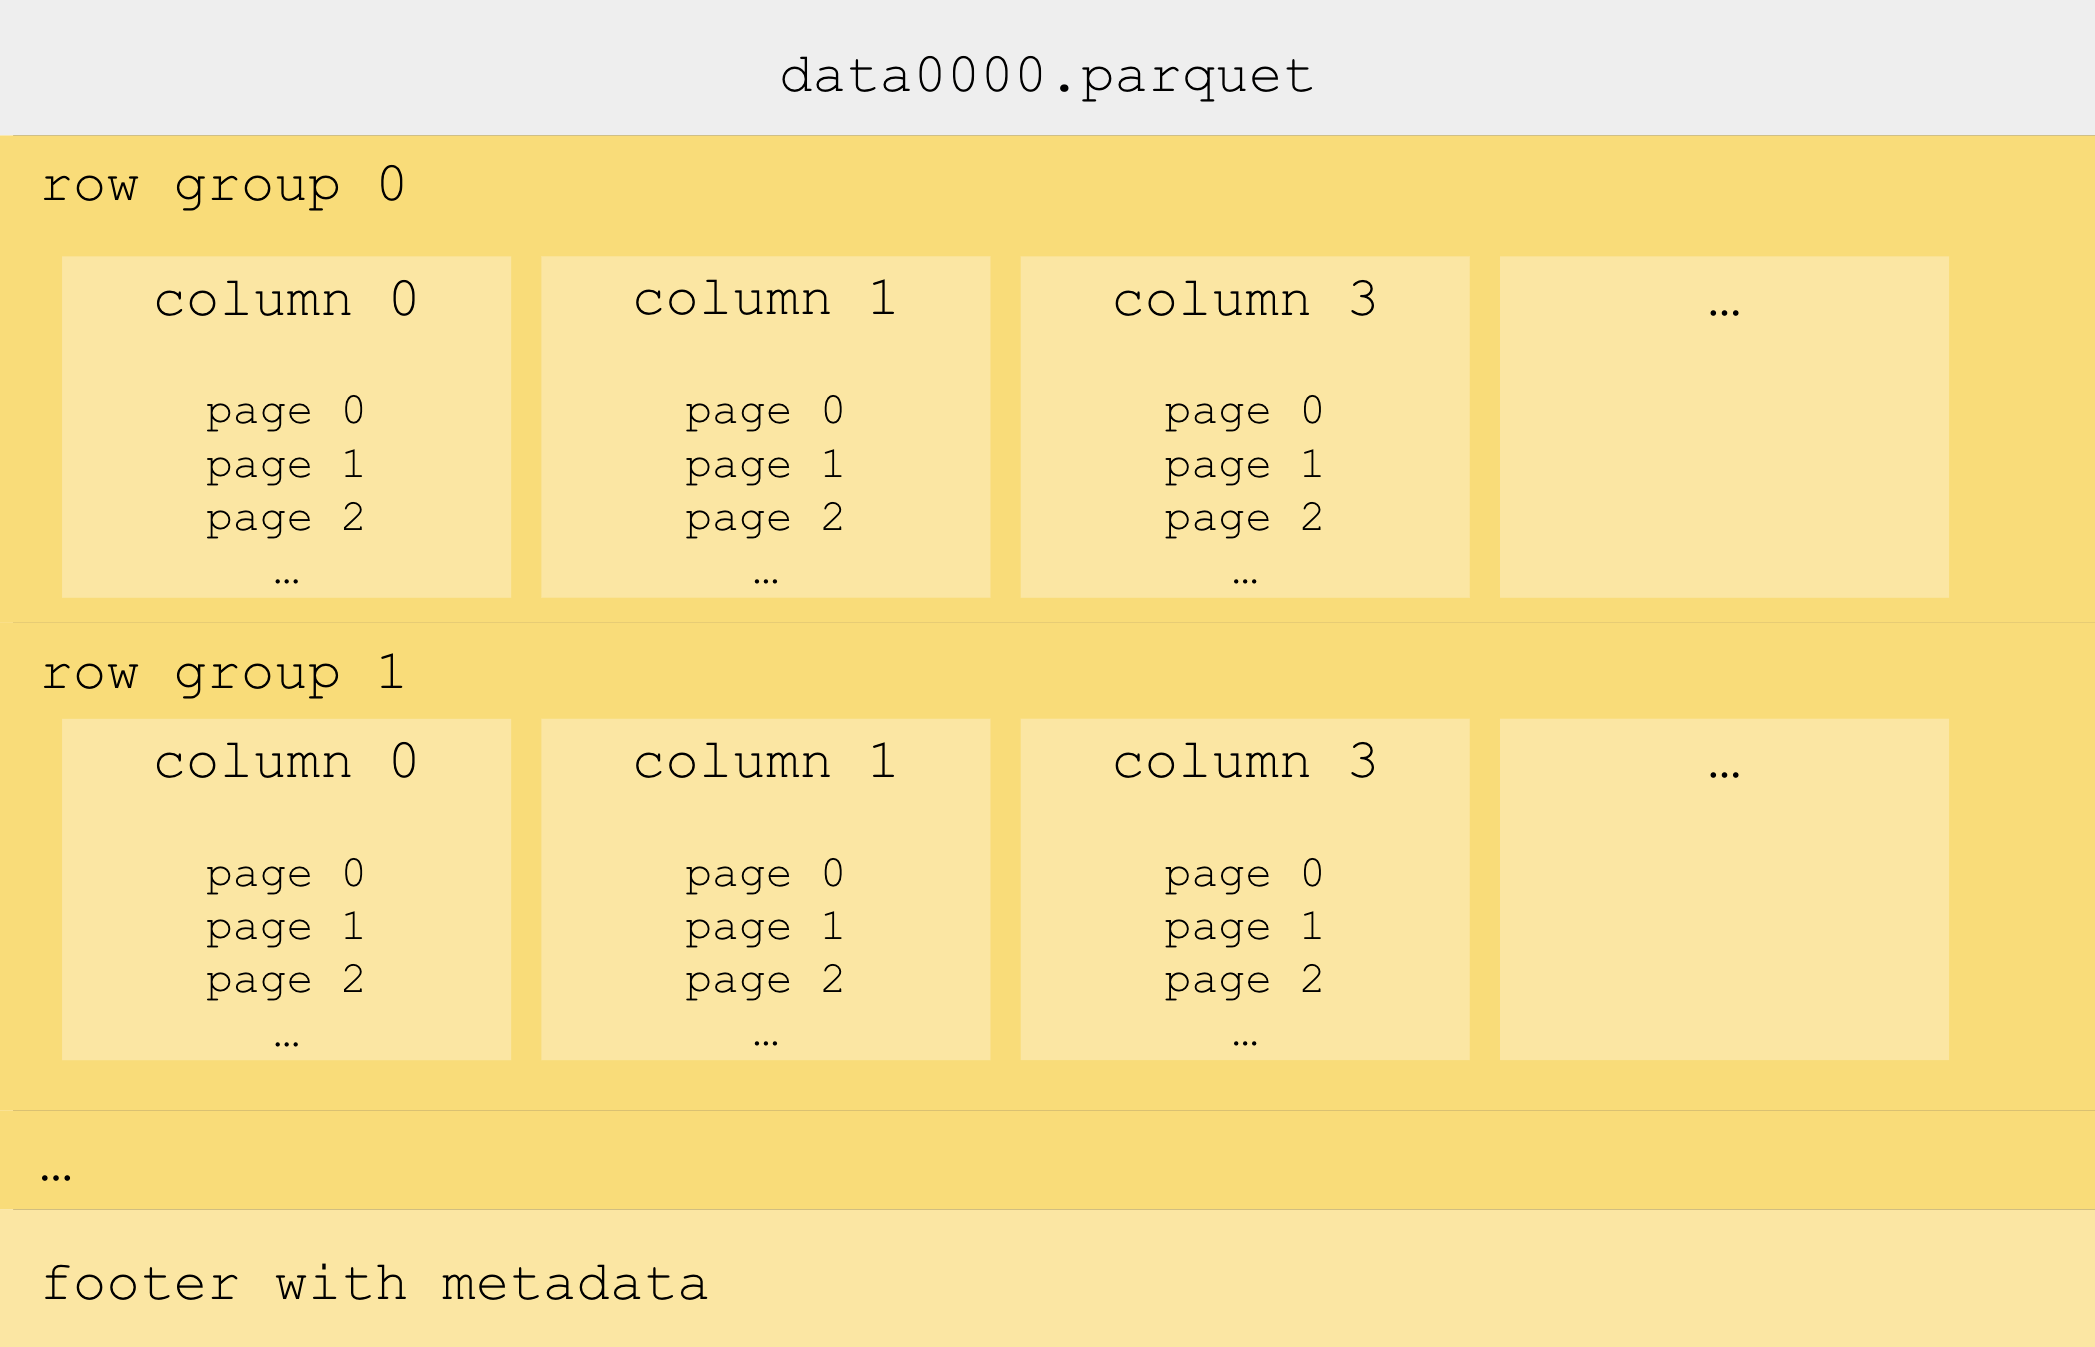
Satır Gruplarını Akıt
Hugging Face'teki Parquet dosyalarından satır gruplarını akış olarak almak için PyArrow kullanın:
import pyarrow.parquet as pq

repo_id = "HuggingFaceFW/finewiki"
path_in_repo = "data/enwiki/000_00000.parquet"

# Stream the Parquet file row group per row group
with pq.ParquetFile(f"hf://datasets/{repo_id}/{path_in_repo}") as pf:
    for row_group_idx in range(pf.num_row_groups):
        row_group_table = pf.read_row_group(row_group_idx)
        df = row_group_table.to_pandas()
PyArrow,
hf://yollarını kutudan çıktığı gibi destekler veHfFileSystembileşenini otomatik olarak kullanır
Daha fazla bilgi için PyArrow belgelerine göz atın.
Verimli rastgele erişim
Satır grupları sütunlara, sütunlar da sayfalara ayrılır. Sayfalar genellikle 1 MB civarındadır ve sıkıştırmanın uygulandığı yer olduğu için Parquet'teki en küçük veri birimidir. Sayfalara erişim, tam bir satır grubunu yüklemek zorunda kalmadan belirli satırların yüklenmesini sağlar ve Parquet dosyasında bir sayfa dizini varsa mümkündür. Ancak her Parquet çerçevesi sayfa düzeyinde okumayı desteklemez. Örneğin PyArrow bunu desteklemez, ancak Rust'taki parquet crate'i destekler:
use std::sync::Arc;
use object_store::path::Path;
use object_store_opendal::OpendalStore;
use opendal::services::Huggingface;
use opendal::Operator;
use parquet::arrow::async_reader::ParquetObjectReader;
use parquet::arrow::ParquetRecordBatchStreamBuilder;
use futures::TryStreamExt;

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let repo_id = "HuggingFaceFW/finewiki";
    let path_in_repo = Path::from("data/enwiki/000_00000.parquet");
    let offset = 0;
    let limit = 10;

    let builder = Huggingface::default().repo_type("dataset").repo_id(repo_id);
    let operator = Operator::new(builder)?.finish();
    let store = Arc::new(OpendalStore::new(operator));
    let reader = ParquetObjectReader::new(store, path_in_repo.clone());
    let batch_stream =
        ParquetRecordBatchStreamBuilder::new(reader).await?
            .with_offset(offset as usize)
            .with_limit(limit as usize)
            .build()?;
    let results = batch_stream.try_collect::<Vec<_>>().await?;
    println!("Read {} batches", results.len());
    Ok(())
}
Rust'ta, Python'daki
HfFileSystem'e eşdeğer olan OpenDAL'inHuggingfacehizmetini kullanıyoruz.
PyArrow'da write_page_index=True parametresini geçerek, verimli rastgele erişimi sağlayan sayfa indeksini dahil edin.
Bu, Hugging Face'teki Parquet metadata görüntüleyicisinde görebileceğiniz Parquet sütunlarına özellikle “offset_index_offset” ve “offset_index_length” alanlarını ekler.
Sayfa indeksleri ayrıca Hugging Face Dataset Viewer'ın hızını artırır ve satır grubu boyutu sınırı olmadan veri göstermesine olanak tanır.