
Hub documentation
在 Hugging Face 上使用 Sentence Transformers
在 Hugging Face 上使用 Sentence Transformers
sentence-transformers 是一个提供便捷方法来计算句子、段落和图像嵌入(稠密向量表示)的库。文本被嵌入到向量空间中,使得相似的文本彼此靠近,从而支持语义搜索、聚类和检索等应用。
在 Hub 中探索 sentence-transformers
在模型页面左侧进行筛选,可以找到超过 500 个sentence-transformer模型。这些模型中的大多数支持不同的任务,例如通过feature-extraction生成嵌入,以及使用sentence-similarity来判断给定句子与其他句子的相似度。您还可以在官方文档中查看官方预训练模型的概览。
Hub 上的所有模型都附带以下功能:
- 自动生成的模型卡片,包含描述、示例代码片段、架构概览等内容。
- 有助于提高可发现性并包含许可证等信息的元数据标签。
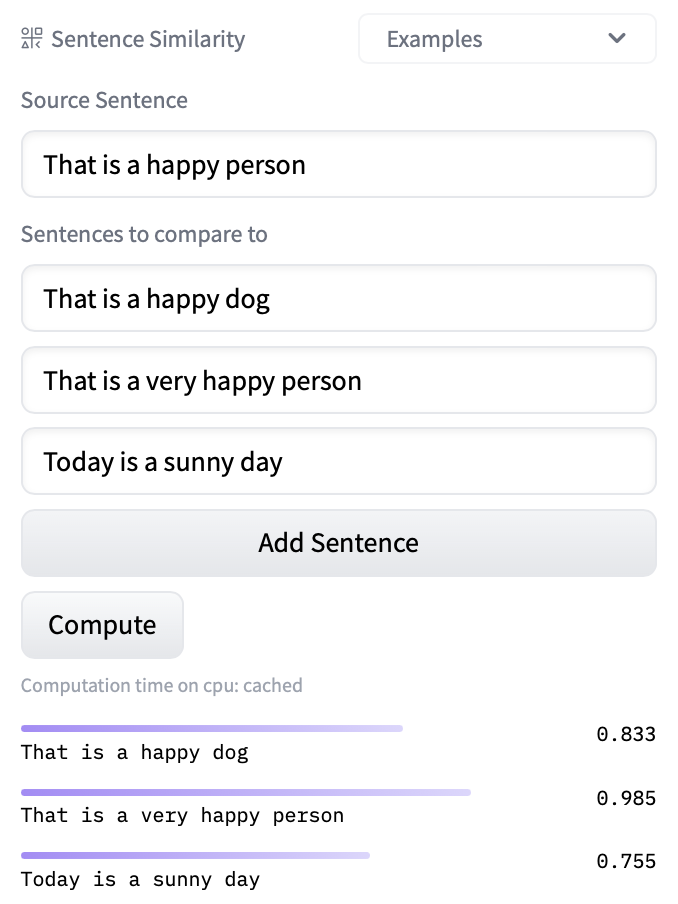
- 一个交互式小部件,可直接在浏览器中用于体验该模型。
- 一个用于发起推理请求的 Inference Providers 小部件。

使用现有模型
Hub 上的预训练模型可以通过一行代码加载
from sentence_transformers import SentenceTransformer
model = SentenceTransformer('model_name')
下面是一个示例,它先对句子进行编码,然后计算它们之间的距离,以实现语义搜索。
from sentence_transformers import SentenceTransformer, util
model = SentenceTransformer('multi-qa-MiniLM-L6-cos-v1')

query_embedding = model.encode('How big is London')
passage_embedding = model.encode(['London has 9,787,426 inhabitants at the 2011 census',
                                  'London is known for its financial district'])

print("Similarity:", util.dot_score(query_embedding, passage_embedding))
如果你想了解如何加载特定模型,可以单击 Use in sentence-transformers,即可获得一个可直接用于加载该模型的代码片段!


共享您的模型
您可以使用训练好的模型的 save_to_hub 方法来共享您的 Sentence Transformers。
from sentence_transformers import SentenceTransformer

# Load or train a model
model.save_to_hub("my_new_model")此命令会创建一个包含自动生成的模型卡片、推理小部件、示例代码片段等内容的仓库。此处提供了一个示例。