
LeRobot documentation
LIBERO
LIBERO
The commands below run the simulator locally. To keep its dependencies away from your policy's, serve it instead with `lerobot-env-server --config_path=docker/sim/configs/libero.yaml --sim.task=--docker=true`, where ` ` is the command's `--env.task`, and add `--env.server.endpoint=tcp/127.0.0.1:7448` to the command. A server runs the task it was started with (see [Simulation: local or served](./simulation)).
LIBERO es un benchmark diseñado para estudiar el aprendizaje vitalicio de robots: la idea de que los robots deben seguir aprendiendo y adaptándose a sus usuarios con el tiempo, y no solo ser preentrenados una vez. Proporciona un conjunto de tareas de manipulación estandarizadas que se centran en la transferencia de conocimiento: qué tan bien puede un robot aplicar lo que ya ha aprendido a nuevas situaciones. Al evaluar en LIBERO, se pueden comparar de manera justa diferentes algoritmos y los investigadores pueden construir sobre el trabajo de otros.
- Artículo: Benchmarking Knowledge Transfer for Lifelong Robot Learning
- GitHub: Lifelong-Robot-Learning/LIBERO
- Sitio web del proyecto: libero-project.github.io
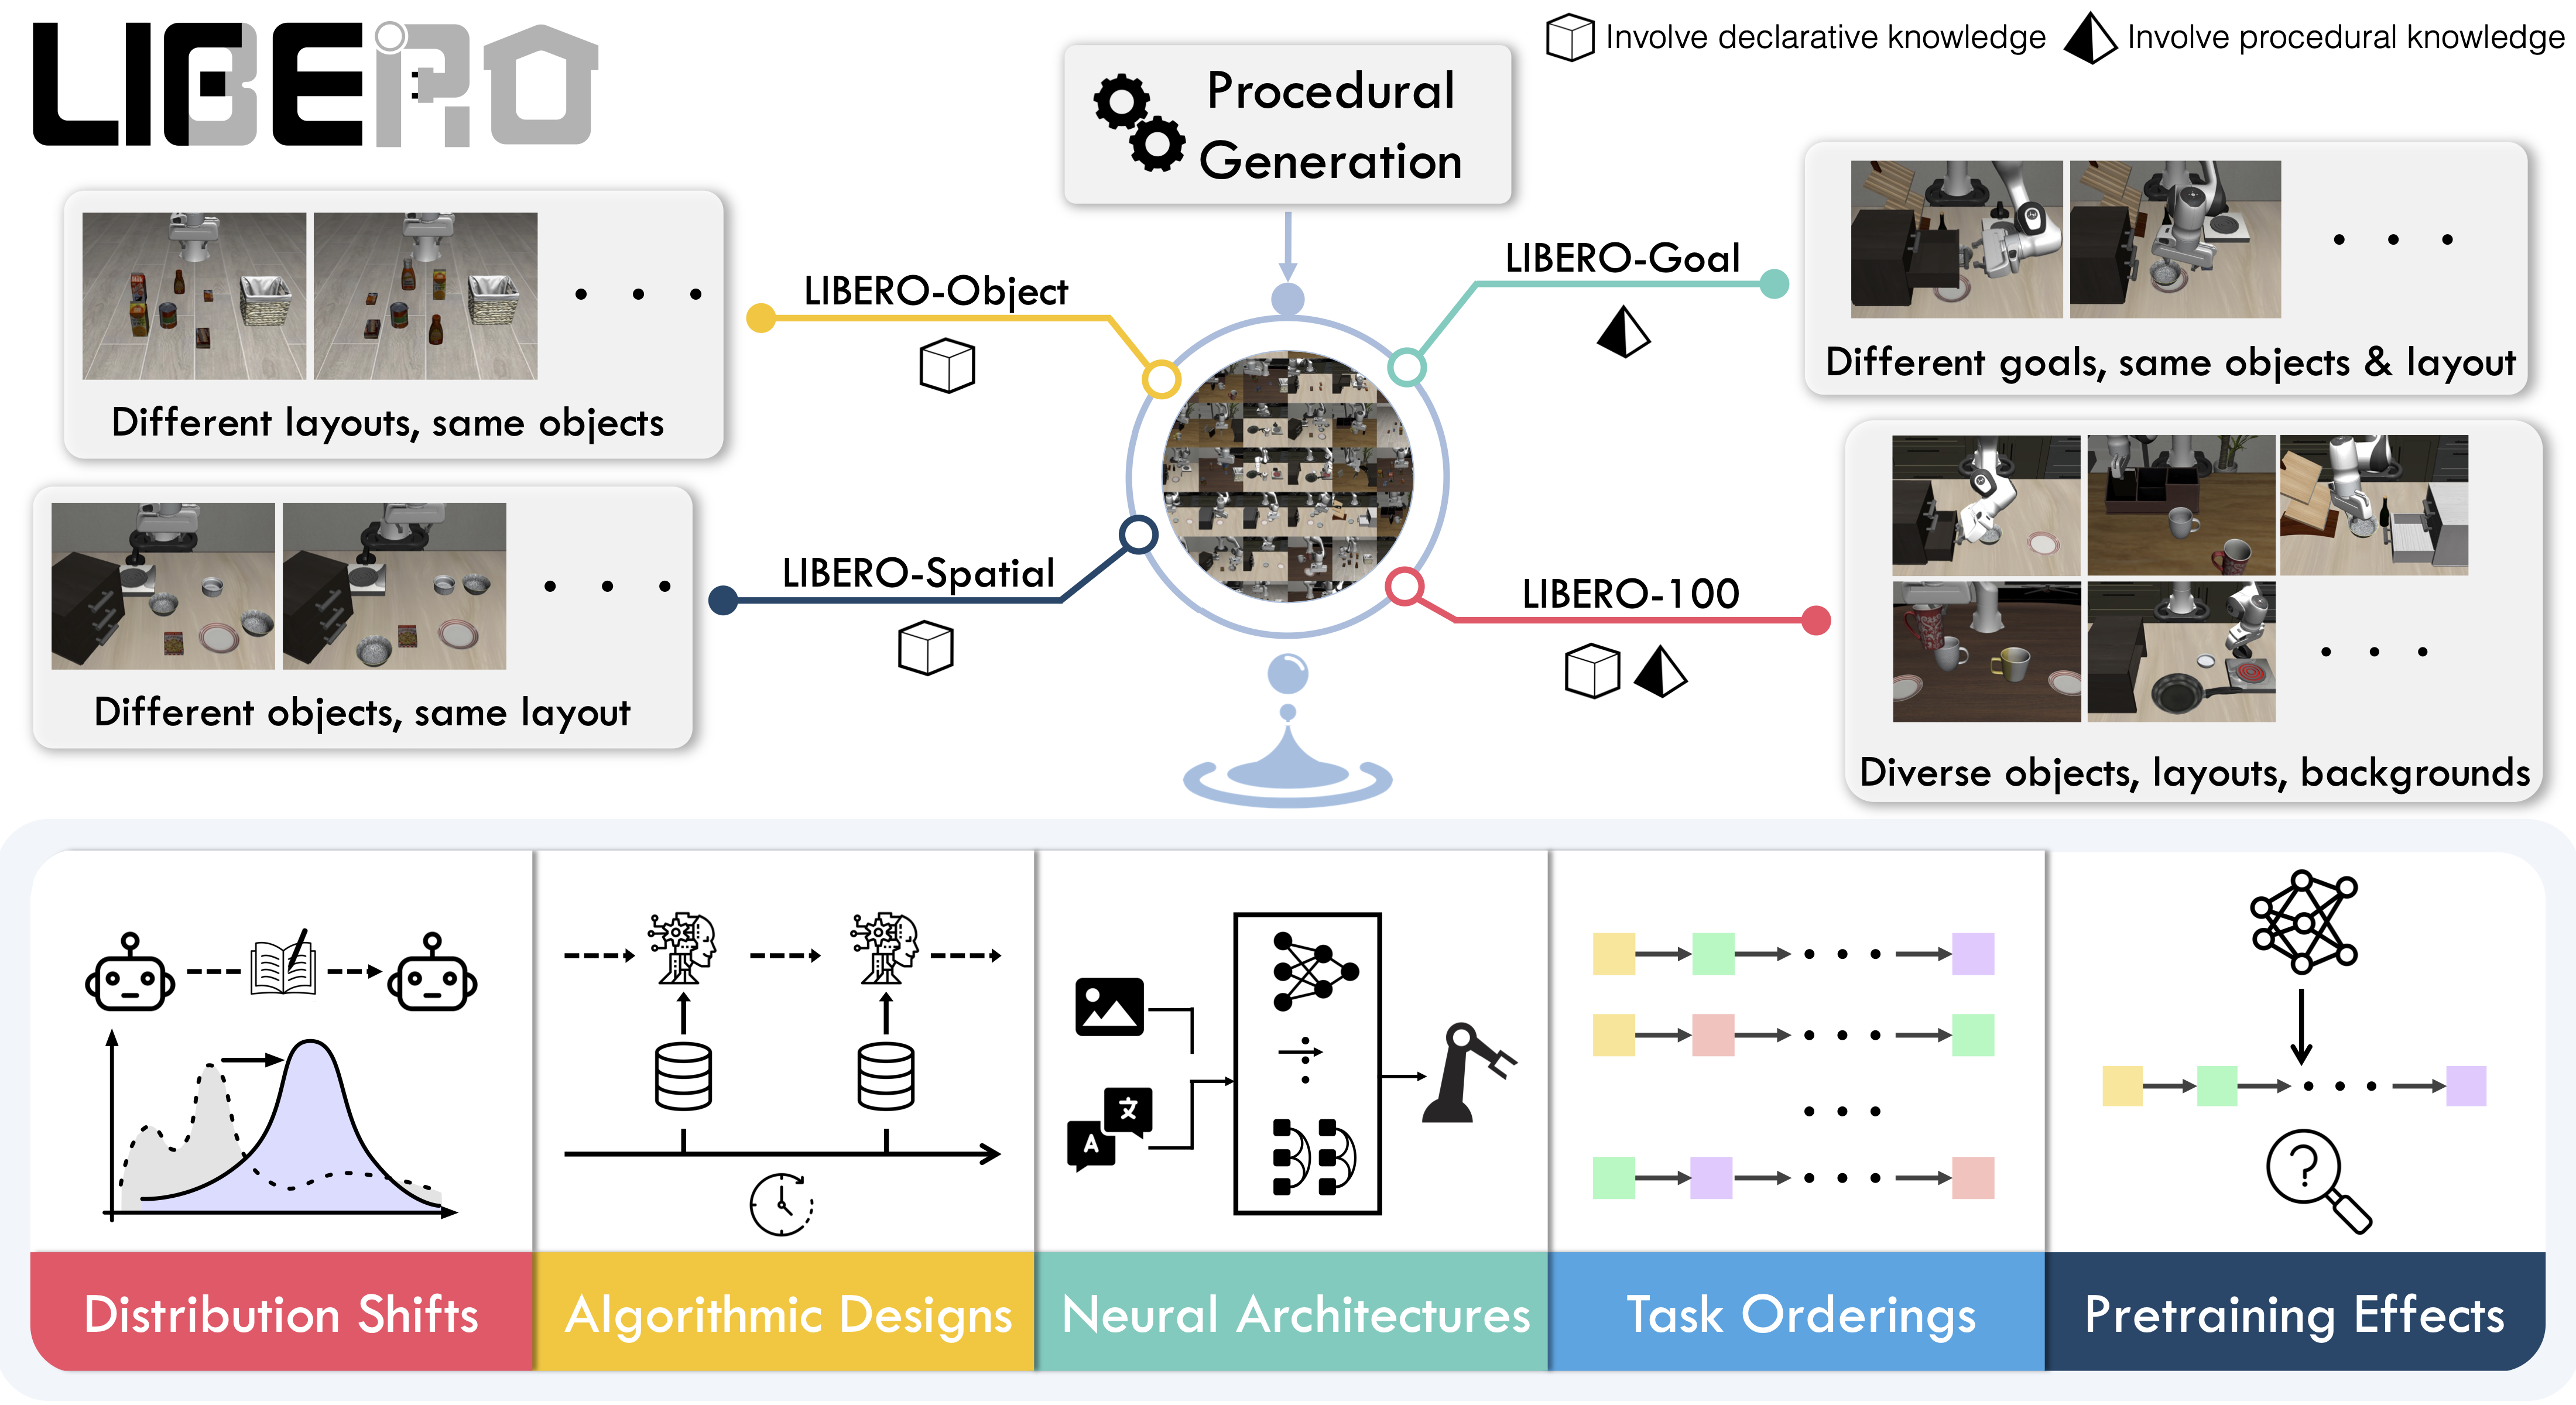
Tareas disponibles
LIBERO incluye cinco suites de tareas que abarcan 130 tareas, desde manipulaciones de objetos simples hasta escenarios complejos de varios pasos:
| Suite | Nombre de la CLI | Tareas | Descripción |
|---|---|---|---|
| LIBERO-Spatial | libero_spatial | 10 | Tareas que requieren razonamiento sobre relaciones espaciales |
| LIBERO-Object | libero_object | 10 | Tareas centradas en la manipulación de diferentes objetos |
| LIBERO-Goal | libero_goal | 10 | Tareas condicionadas por objetivos con metas cambiantes |
| LIBERO-90 | libero_90 | 90 | Tareas de horizonte corto de la colección LIBERO-100 |
| LIBERO-Long | libero_10 | 10 | Tareas de horizonte largo de la colección LIBERO-100 |
Instalación
Tras seguir las instrucciones de instalación de LeRobot:
pip install -e ".[libero]"LIBERO requires Linux (`sys_platform == 'linux'`). LeRobot uses MuJoCo for simulation — set the rendering backend before training or evaluation:export MUJOCO_GL=egl # for headless servers (HPC, cloud)
Evaluación
Evaluación local predeterminada
Evalúe en las cuatro suites estándar (10 episodios por tarea):
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --env.max_parallel_tasks=1
Evaluación de un solo conjunto
Evaluar en un solo conjunto de LIBERO:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object \
  --eval.batch_size=2 \
--eval.n_episodes=3--env.taskselecciona la suite (libero_object,libero_spatial, etc.).--env.task_idsrestringe la ejecución a índices de tareas específicos ([0],[1,2,3], etc.). Omita este parámetro para ejecutar todas las tareas de la suite.--eval.batch_sizecontrola cuántos entornos se ejecutan en paralelo.--eval.n_episodesdefine cuántos episodios se ejecutan por tarea.
Evaluación multi-suite
Ejecute una política en varias suites a la vez pasando una lista separada por comas:
lerobot-eval \
  --policy.path="your-policy-id" \
  --env.type=libero \
  --env.task=libero_object,libero_spatial \
  --eval.batch_size=1 \
  --eval.n_episodes=2
Modo de control
LIBERO admite dos modos de control: relative (predeterminado) y absolute. Los distintos puntos de control de VLA se entrenan con diferentes parametrizaciones de acción, por lo que asegúrese de que el modo coincida con su política:
--env.control_mode=relative # or "absolute"Restablecer el rendimiento
Por defecto, LeRobot conserva el comportamiento de reinicio duro de LIBERO. Con los estados iniciales fijos habilitados, puedes optar por reinicios suaves para omitir la reconstrucción del modelo del simulador y del renderizador en cada episodio:
--env.init_states=true --env.hard_reset=falseLos reinicios suaves son más rápidos, pero no son idénticos a nivel de bit a los reinicios duros después de los pasos de estabilización del entorno, por lo que las observaciones de la cámara y los resultados de la política pueden diferir ligeramente. Utilice reinicios duros al reproducir resultados de benchmarks.
Entradas y salidas de la política
Observaciones:
observation.state— características propioceptivas de 8 dimensiones (posición del eef, orientación axis-angle, qpos del agarre)observation.images.image— vista de la cámara principal (agentview_image), HWC uint8observation.images.image2— vista de la cámara de la muñeca (robot0_eye_in_hand_image), HWC uint8
LeRobot enforces the `.images.*` prefix for visual features. Ensure your policy config `input_features` use the same naming keys, and that your dataset metadata keys follow this convention. If your data contains different keys, you must rename the observations to match what the policy expects, since naming keys are encoded inside the normalization statistics layer.
Acciones:
- Control continuo en
Box(-1, 1, shape=(7,))— delta de efector final 6D + pinza 1D
Episodios de evaluación recomendados
Para realizar benchmarks reproducibles, use 10 episodios por tarea en las cuatro suites estándar (Spatial, Object, Goal, Long). Esto da un total de 400 episodios y coincide con el protocolo utilizado para los resultados publicados. Las tasas de éxito pueden variar en unos pocos porcentajes entre semillas de evaluación, por lo que recomendamos promediar sobre 3 semillas.
lerobot-eval informa un intervalo de Wilson del 95% (pc_success_ci95) junto a cada tasa de éxito. Con 10 episodios, una tarea con una puntuación de 9/10 tiene un intervalo de aproximadamente 60% a 98%, y un total de 400 episodios con un 80% tiene uno de aproximadamente 76% a 84%. Dos políticas cuyos intervalos se solapan en una tarea no han demostrado diferir en esa tarea según esa ejecución. El intervalo cubre qué episodios se extrajeron; no cubre la semilla de entrenamiento de la política, lo cual requiere más de una ejecución de entrenamiento para medirse.
To compare two policies on the same episodes, use the same `--seed`, keep `--env.init_states=true`, and run each task in a single batch (`--eval.batch_size` equal to episodes per task).
Entrenamiento
Dataset
Dos conjuntos de datos LIBERO preprocesados son totalmente compatibles con LeRobot. Contienen las mismas demostraciones con el mismo esquema y difieren en cómo se almacenan los fotogramas de la cámara:
| lerobot/libero | HuggingFaceVLA/libero | |
|---|---|---|
| episodios / fotogramas / tareas | 1,693 / 273,465 / 40 | 1,693 / 273,465 / 40 |
| cámaras | 2× 256×256×3 | 2× 256×256×3 |
| dimensiones de estado / acción | 8 / 7 | 8 / 7 |
| formato de dataset | v3.0 | v3.0 |
| codificación de cámara | Video MP4 | PNG en parquet |
| tamaño de descarga | 1,9 GB | 69.9 GB |
| dependencia adicional | backend de video (torchcodec o pyav) | none |
Recomendamos lerobot/libero: descarga 37 veces más pequeña con velocidad de carga equivalente (~330 muestras/s por worker). La recodificación de video es ligeramente con pérdida; use la variante basada en imágenes si no puede instalar un backend de decodificación de video.
Para referencia, el conjunto de datos original publicado por Physical Intelligence:
Pin `--dataset.revision=` when reporting results — Hub datasets can be re-uploaded, and success rates are only comparable against the same data revision.
Ejemplo de comando de entrenamiento
Entrena SmolVLA en el conjunto de datos recomendado:
lerobot-train \
  --policy.type=smolvla \
  --policy.load_vlm_weights=true \
  --policy.push_to_hub=false \
  --dataset.repo_id=lerobot/libero \
  --dataset.video_backend=torchcodec \
  --output_dir=./outputs/libero_smolvla \
  --steps=100000 \
  --batch_size=64
Para compartir el resultado en el Hub, reemplace --policy.push_to_hub=false por --policy.repo_id=${HF_USER}/libero-smolvla. Evalúe los puntos de control guardados con lerobot-eval como se muestra en la sección Evaluación.
Reproducción de resultados publicados
Reproducimos los resultados de Pi0.5 en el benchmark LIBERO. Tomamos el modelo base de LIBERO de Physical Intelligence (pi05_libero) y lo afinamos durante 6k pasos adicionales en bfloat16, con un tamaño de lote de 256 en 8 GPUs H100, utilizando el conjunto de datos LIBERO de HuggingFace.
El modelo afinado: lerobot/pi05_libero_finetuned
Comando de evaluación
lerobot-eval \
  --output_dir=./eval_logs/ \
  --env.type=libero \
  --env.task=libero_spatial,libero_object,libero_goal,libero_10 \
  --eval.batch_size=1 \
  --eval.n_episodes=10 \
  --policy.path=lerobot/pi05_libero_finetuned \
  --policy.n_action_steps=10 \
  --env.max_parallel_tasks=1
Establecemos n_action_steps=10, en concordancia con la implementación original de OpenPI.
Resultados
| Modelo | LIBERO Espacial | LIBERO Object | Objetivo de LIBERO | LIBERO 10 | Promedio |
|---|---|---|---|---|---|
| Pi0.5 (LeRobot) | 97.0 | 99.0 | 98.0 | 96.0 | 97.5 |
Estos resultados son coherentes con los resultados originales reportados por Physical Intelligence:
| Modelo | LIBERO Espacial | LIBERO Object | Objetivo de LIBERO | LIBERO 10 | Promedio |
|---|---|---|---|---|---|
| Pi0.5 (OpenPI) | 98.8 | 98.2 | 98.0 | 92.4 | 96.85 |