
Hub documentation
Menggunakan Sentence Transformers di Hugging Face
Menggunakan Sentence Transformers di Hugging Face
sentence-transformers adalah pustaka yang menyediakan metode mudah untuk menghitung embedding (representasi vektor padat) untuk kalimat, paragraf, dan gambar. Teks di-embed ke dalam ruang vektor sehingga teks yang serupa berada berdekatan, yang memungkinkan aplikasi seperti pencarian semantik, pengelompokan, dan pengambilan.
Menjelajahi sentence-transformers di Hub
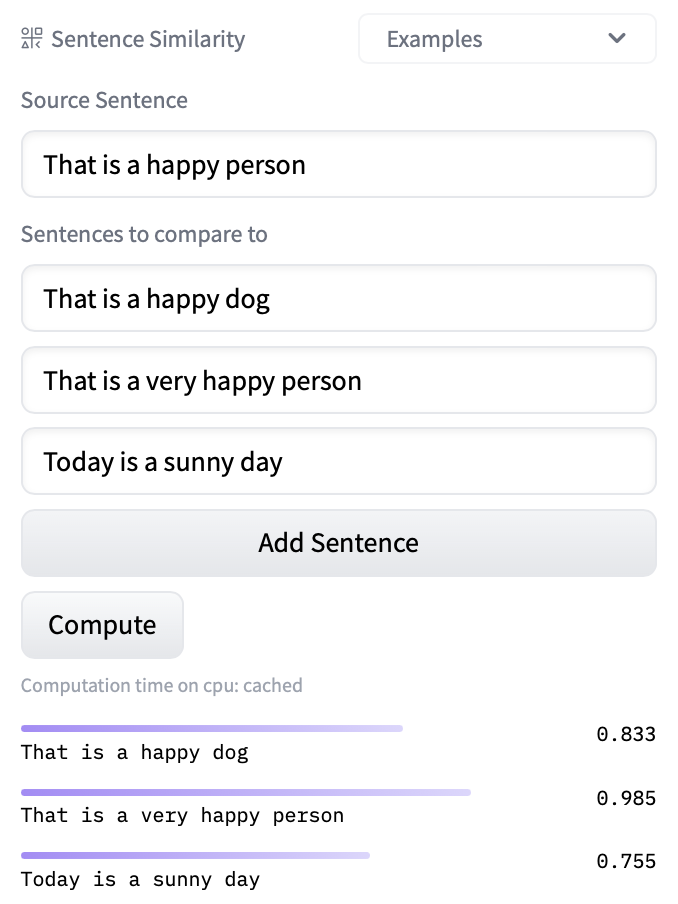
Anda dapat menemukan lebih dari 500 model sentence-transformer dengan memfilter di sisi kiri halaman model. Sebagian besar model ini mendukung berbagai tugas, seperti melakukan feature-extraction untuk menghasilkan embedding, dan sentence-similarity sebagai cara untuk menentukan seberapa mirip suatu kalimat dengan kalimat lainnya. Anda juga dapat menemukan ringkasan model pre-trained resmi di dokumentasi resmi.
Semua model di Hub dilengkapi dengan fitur:
- Kartu model yang dihasilkan secara otomatis dengan deskripsi, cuplikan kode contoh, ringkasan arsitektur, dan lainnya.
- Tag metadata yang membantu keterdapatannya dan berisi informasi seperti lisensi.
- Widget interaktif yang dapat Anda gunakan untuk bermain langsung dengan model di browser.
- Widget Inference Providers yang memungkinkan Anda membuat permintaan inferensi.

Menggunakan model yang sudah ada
Model-model terlatih di Hub dapat dimuat dengan satu baris kode
from sentence_transformers import SentenceTransformer
model = SentenceTransformer('model_name')
Berikut adalah contoh yang mengkodekan kalimat dan kemudian menghitung jarak di antara mereka untuk melakukan pencarian semantik.
from sentence_transformers import SentenceTransformer, util
model = SentenceTransformer('multi-qa-MiniLM-L6-cos-v1')

query_embedding = model.encode('How big is London')
passage_embedding = model.encode(['London has 9,787,426 inhabitants at the 2011 census',
                                  'London is known for its financial district'])

print("Similarity:", util.dot_score(query_embedding, passage_embedding))
Jika Anda ingin melihat cara memuat model tertentu, Anda dapat mengklik Use in sentence-transformers dan Anda akan diberikan potongan kode yang berfungsi untuk memuatnya!


Berbagi model Anda
Anda dapat membagikan Sentence Transformers Anda dengan menggunakan metode save_to_hub dari model yang telah dilatih.
from sentence_transformers import SentenceTransformer

# Load or train a model
model.save_to_hub("my_new_model")
Perintah ini membuat repositori dengan kartu model yang dihasilkan secara otomatis, widget inferensi, cuplikan kode contoh, dan lainnya! Di sini adalah contohnya.
Sumber daya tambahan
- Library library Sentence Transformers.
- Dokumentasi Sentence Transformers docs.
- Integrasi dengan pengumuman Hub.